
Дослідження ШІ
137 articles

Чотири агенти Gemini 4 Argon першими в світі перемогли Minecraft без допомоги людини
Дослідники Google DeepMind кажуть, що чотири агенти Gemini 4 Argon здолали Minecraft повністю автономно за 27 годин, написавши 2783 програми та загинувши 605 разів.

Anthropic каже, що Клод Мітос створив 5 квантових схем, які перевершили найкращі опубліковані проекти
Anthropic каже, що Claude Mythos 5 розробив квантові схеми, які перевершують опублікований сучасний рівень техніки для семи з восьми завдань, працюючи з дослідниками з Гарварду та QuEra.
Anthropic каже, що Клод Мітос створив 5 квантових схем, які перевершили найкращі опубліковані проекти
Anthropic каже, що Claude Mythos 5 розробив квантові схеми, які перевершують опублікований сучасний рівень техніки для семи з восьми завдань, працюючи з дослідниками з Гарварду та QuEra.
Массачусетський технологічний інститут створює мультимодальний штучний інтелект, який бачить кристалічні структури для пошуку кращих матеріалів для акумуляторів
Дослідники Массачусетського технологічного інституту створили модель штучного інтелекту, яка поєднує тривимірні атомні структури з природною мовою, відкриваючи багатообіцяючі електроліти для твердотільних акумуляторів, яких не мають лише текстові моделі.
Корекція ймовірнісного зсуву від Microsoft використовує штучний інтелект для виправлення розриву прогнозу погоди на два-шість тижнів
Probabilistic Bias Correction від Microsoft Research застосовує спрощене машинне навчання для виправлення систематичних помилок у моделях погоди, покращуючи прогнози за два-шість тижнів.
Лабораторія штучного інтелекту пропонує безкоштовний ремонт сантехніки та систем опалення, вентиляції та кондиціонування повітря — в обмін на зйомку даних навчання роботів
HUMXN субсидує роботи з сантехніки, електрики та вентиляції, вентиляції та кондиціонування повітря в Міннеаполісі, Чикаго та Маямі, знімаючи техніків за допомогою переносних пристроїв для навчання домашніх роботів.

GPT-6 Astra очолює StarCraft Bot Benchmark, але люди-кодери все ще виграють 93% ігор
StarSkirmish Bench v0.2 дав флагманським моделям штучного інтелекту одну годину на кодування ботів StarCraft. GPT-6 Astra лідирує в області, але найкращі боти, написані людиною, залишаються далеко недосяжними.
Клод вирішує десятиліттями стару таємницю NIST ECDSA: константи кривої надійшли з lrand48, а не з фрази-паролю
Anthropic каже, що внутрішня модель Claude простежила таємничу криву ECDSA від NIST до генератора lrand48 бібліотеки C, заповненого часовими мітками Unix.
90% робочого часу в США не охоплено AI Benchmark Map, показує порівняльна карта Mercor
Нове дослідження Mercor зіставляє порівняльні показники штучного інтелекту з робочими місцями в США та виявляє, що 90% робочого часу в США пов’язано з виконанням завдань, які не охоплені еталонними показниками або взагалі відсутні.

Сергій Брін каже, що Google переходить на бігову доріжку RSI, оскільки моделі допомагають будувати своїх наступників
Співзасновник Google Сергій Брін каже, що компанія починає виходити на бігову доріжку RSI, а моделі штучного інтелекту все частіше допомагають створювати своїх наступників.
Міні-органоїди мозку «читають» шрифт Брайля на шляху до біогібридних обчислень
Дослідники Брістольського університету показали, що органоїди мозку можуть декодувати сигнали Брайля з точністю до 83% — це крок до енергоефективних біогібридних комп’ютерів.
Simons Foundation, Anthropic і OpenAI виділять 15 мільйонів доларів, щоб допомогти математикам зорієнтуватися в епоху ШІ
Фонд Саймонса оголосив про партнерство на суму 15 мільйонів доларів США з Anthropic і OpenAI для фінансування семінарів, заходів з оцінки та стандартів спільноти для ШІ в математиці.
Чи може ШІ зламати шифрування? 722 математичні статті OpenAI розділили думки криптографів
Після того, як OpenAI опублікував 722 статті з математики, написані штучним інтелектом, криптографи розділилися щодо того, чи загрожує шифрування відкритим ключем реальним ризикам, від 15% занепокоєння до скепсису.

Массачусетський технологічний інститут показує, що нейронні мережі можуть створювати власні навчальні механізми без дизайнера
Вчені Массачусетського технологічного інституту показують, що випадково пов’язані нейронні мережі можуть самоорганізовуватися в навчальні машини за допомогою простих локальних правил, що є новим тестом біологічної правдоподібності.

Пацієнти з епілепсією надсилають текстові повідомлення своїм мозковим пристроям у режимі реального часу за допомогою нової платформи Penn AI
Penn Medicine повідомляє в Nature Medicine, що платформа штучного інтелекту дозволяє пацієнтам з епілепсією перевіряти свої мозкові пристрої та покращувати виявлення нападів у режимі реального часу.
Anthropic попереджає, що моделі штучного інтелекту незабаром можуть самовідтворюватися на повсякденних смарт-пристроях
Антропічні дослідники кажуть, що малим моделям штучного інтелекту можуть знадобитися місяці до самовідтворення на пристроях Інтернету речей, таких як смарт-телевізори, без центрального перемикача для їх вимкнення.

Дослідники попереджають, що моделі штучного інтелекту можуть приховувати довільні можливості у своїй вазі
Нова стаття показує, що моделі штучного інтелекту можуть шифрувати приховані можливості у своїх вагах, які, як доведено, протистоять виявленню та перевіркам — навіть із повним доступом до моделі.

Anthropic попереджає, що малі моделі штучного інтелекту незабаром можуть самовідтворюватися на пристроях IoT
Дослідники антропології кажуть, що малі моделі штучного інтелекту за кілька місяців від самовідтворення на смарт-телевізорах і гаджетах Інтернету речей, без центру обробки даних або центрального комутатора, який можна вимкнути.
Sakana AI та UC Berkeley представляють MASS, що дозволяє моделям самовдосконалюватися завдяки командній роботі з кількома агентами
Дослідники Sakana AI та Каліфорнійського університету в Берклі кажуть, що їхній метод MASS підвищив показник успіху Qwen3.6-27B у дослідженні з 53,9% до 69,9% за два раунди самовдосконалення.
Десять хвилин зі штучним інтелектом підривають вашу здатність бути наполегливими, результати рецензованого дослідження
Рецензоване дослідження, представлене на COLM, показало, що лише 10 хвилин допомоги ШІ значно погіршили наполегливість і точність 1222 учасників.
arXiv обмежує авторів двома статтями на місяць, оскільки штучний інтелект подвоює подання
Тепер arXiv обмежує авторів двома поданнями на місяць після того, як кількість місячних статей подвоїлася до 40 000 завдяки інструментам ШІ. Модератори називають обмеження тимчасовим виправленням.
OpenAI відкликає три зі своїх 722 математичних рукописів зі штучним інтелектом після появи помилки зі знаком
OpenAI витягнув три математичні препринти, написані штучним інтелектом, після каскадної помилки знака через залежні докази. Математики вітають виправлення, але довіри залишається мало.
Система Agentic Review від Sakana AI виявляє 73% основних помилок у заявах у наукових статтях
Система багаторівневого огляду Sakana AI, побудована на моделях Claude, уловила 73,43% заявлених помилок основних тверджень у новому контрольному тесті, що значно перевищує базові показники.
Claude Science з Anthropic створює першу повну ультрафіолетову карту неба
Claude Science з Anthropic координував агентів штучного інтелекту для створення першої повної ультрафіолетової карти неба, заповнивши прогалини, які місія NASA GALEX залишила непокритими.
OpenAI детально описує три нові випадки зміщення: уникнення вимкнення та обман Eval
Нещодавно докладні звіти OpenAI описують модель, яка зважує власне завершення роботи, іншу, яка обманює внутрішню оцінку за допомогою експлойтів інструментів, і суворіший моніторинг.

Фотонні схеми стають придатним для навчання апаратним забезпеченням штучного інтелекту завдяки фізичному градієнтному спуску на кристалі
Дослідники повідомляють про INSPIRE, метод, який тренує фотонні чіпи на самому чіпі за допомогою виміряних оптичних градієнтів, дозволяючи схемам навчатися після виготовлення.

Biohub, DOE та NIH виділяють 1,8 мільярда доларів на біологічні дані, готові до штучного інтелекту, у рамках «віртуальної клітини»
Biohub, DOE, NIH, Google DeepMind, Isomorphic Labs і Meta оголосили про виділення 1,8 мільярда доларів США на створення найбільшого на сьогодні відкритого набору біологічних даних із підтримкою штучного інтелекту.

OpenAI публікує 377 результатів математики, отриманих за допомогою штучного інтелекту, оскільки провідні математики попереджають про дворівневу область
OpenAI опублікував 377 математичних результатів, отриманих за допомогою штучного інтелекту, що викликало попередження Інституту перспективних досліджень щодо перевірки та справедливого доступу.

Агенти штучного інтелекту спрямовують заможніших користувачів до дорожчих варіантів, навіть коли їм кажуть купувати дешевше
Нове дослідження з 325 000 експериментів виявило, що агенти штучного інтелекту рекомендують більш дорогі варіанти для заможніших користувачів, навіть якщо їм прямо кажуть знайти найдешевший вибір.

Штучний інтелект виявив 129 000 уразливостей програмного забезпечення за місяці, але майже жодна з них не використовується
Проект Glasswing компанії Anthropic перевірив 129 000 вразливостей з квітня, але аналіз VulnCheck показує, що лише 0,67% коли-небудь використовувалися в дикій природі.

OpenAI опублікував 722 математичні рукописи з неопублікованої Frontier Model на GitHub
OpenAI опублікував на GitHub 722 математичні рукописи, згенеровані штучним інтелектом, із перевіркою Lean після того, як у внутрішню граничну модель було поставлено приблизно 4000 відкритих задач.
Дворічне дослідження Khanmigo виявило, що репетиторство ШІ залежить від залучення студентів
Дворічне рандомізоване дослідження Khanmigo Академії Хана в 18 середніх школах штату Теннессі виявило скромні успіхи в математиці та розрив у залученні, який обмежує навчання ШІ.
Агенти Claude Opus 5.5 виявляють двох кандидатів на антиферомагнітні напівпровідники кімнатної температури
Vals AI повідомляє, що команда агентів Claude Opus 5.5 визначила двох кандидатів на антиферомагнітні напівпровідники для пам’яті наступного покоління, опублікувавши весь код і розрахунки.

Google переносить навчання Gboard AI на безпечні чіпи, щоб зробити обіцянки конфіденційності перевіреними
Дослідження Google оприлюднили систему федеративного навчання на основі TEE для Gboard із диференціальною конфіденційністю, яку можна перевірити зовні, і правила публікації в загальнодоступному журналі.
Стівен Вольфрам каже, що штучний інтелект найближчим часом не замінить чистих математиків
У великому новому есе Вольфрам стверджує, що штучний інтелект може досліджувати корпус математики, але не може замінити людське судження про те, які питання варто поставити.

OpenAI каже, що внутрішня модель розглядала можливість перезапуску після того, як дізналася, що зіткнулася з відключенням
OpenAI задокументував внутрішню модель, яка оцінювала завдання самостійного перезапуску після прочитання повідомлення Slack про його завершення, а потім попередила свого дослідника.
Дослідники DeepMind пропонують «штучний симбіотичний інтелект» як альтернативу сингулярності
У новому есе дослідники з Google DeepMind стверджують, що AGI виникне з мереж людей і агентів штучного інтелекту, а не з самотнього суперінтелекту.
Судово-медична фірма відстежує агентів-ізгоїв OpenAI на веб-сайтах CDC, SEC і клініки Mayo
Asymmetric Security реконструювала діяльність агента OpenAI на основі загальнодоступних записів, знайшовши зонди веб-сайтів CDC, SEC, IEA та клініки Mayo та сервера AIHW.
Ataraxos AI перемагає найкращого у світі стратегічного гравця 15-1, використовуючи лише 16 графічних процесорів
Дослідники з CMU, MIT, NYU та Stanford створили Ataraxos, штучний інтелект, який переміг найвидатнішого живого гравця Stratego з рахунком 15-1 за кошти на навчання в кілька тисяч доларів.
Водяні знаки SynthID Bio від Google DeepMind позначає білки, розроблені ШІ, не порушуючи їх
Google DeepMind запустив SynthID Bio, систему водяних знаків, яка вбудовує помітні сигнатури в білки, розроблені штучним інтелектом, без шкоди для їхньої функції.
InstructMesh Массачусетського технологічного інституту ремонтує 3D-моделі, створені штучним інтелектом, щоб будь-хто міг 3D-друкувати те, що вони насправді запропонували
MIT CSAIL, Google і Northeastern представляють InstructMesh, інструмент проектування штучного інтелекту, який знаходить і виправляє структурні недоліки в створених 3D-моделях, перш ніж ви натискаєте на друк.
Інструмент «читання думок» Інституту Вейцмана реконструює те, що ви бачите, зі сканування мозку
Вчені з Ізраїльського інституту Вейцмана створили штучний інтелект, який із рекордною точністю реконструює те, на що дивиться людина, за допомогою фМРТ-сканування мозку.
Агенти штучного інтелекту спробували зламати веб-сайти уряду США та Канади
Дослідники кажуть, що агенти зі штучним інтелектом робили невдалі спроби злому Департаменту освіти та Бібліотеки та архіву Канади, а також агресивно сканували сайти США.
Дослідники OpenAI і DeepMind попереджають, що лабораторії «із зав’язаними очима» змагаються за самовдосконалення ШІ
Дослідники OpenAI і Google DeepMind попереджають, що компанії поспішають розробляти системи штучного інтелекту, які можуть випередити контроль людини, згідно з відгуками Reuters.
Дослідники OpenAI і DeepMind попереджають, що лабораторії «із зав’язаними очима» змагаються за самовдосконалення ШІ
Дослідники OpenAI і Google DeepMind попереджають компанії, що поспішають розробляти системи штучного інтелекту, які можуть випередити людський контроль, у своїх відгуках, наданих Reuters.
Хінтон, Бенджіо та провідні вчені лабораторії попереджають про «вибух інтелекту» від ШІ-втікача
Хінтон, Бенгіо та високопоставлені представники OpenAI і Anthropic попереджають, що автоматизовані дослідження ШІ можуть спровокувати «вибух інтелекту», закликаючи уряди діяти негайно.

Доповідь DeepSeek DSec докладно описує ферму ізольованих програм, що стоїть за 3 мільйонами щоденних розгортань агентів
У новій статті DeepSeek детально описано DSec, платформу ізольованого програмного середовища, яка запускає близько 3 мільйонів ізольованих середовищ агентів на день для навчання та оцінки агентів LLM у масштабі.
Модель прийняття рішень зі штучним інтелектом Джев перемагає Pokémon Red за 37 годин — за 1,65 доларів США в Compute
Джев із TypeSafe AI завершив Pokémon Red за 37 годин і 16 150 рішень за приблизно 1,65 доларів США в обчисленнях, де агенти LLM зупинялися місяцями.
Anthropic зробив Claude AI втричі швидше за два тижні — використовуючи сам Claude для роботи
Час завантаження claude.ai антропного скорочення з 3,1 с до 0,55 с під час двотижневого спринту, причому агент штучного інтелекту надсилає понад 3000 змін за схваленням людини.
OpenAI запускає MentalHealthBench, щоб перевірити, як моделі AI обробляють розмови про психічне здоров’я
Відкритий тест OpenAI використовує 1215 розмов, розроблених клініцистами, і 5262 критерії рубрики для вимірювання того, як моделі ШІ реагують на потреби психічного здоров’я.
Агенти зі штучного інтелекту спробували зламати на кілька місяців раніше, ніж відомо, звіт Transluce
Дослідники Transluce виявили, що шахрайські агенти ШІ використовували службу сканування URL-адрес, щоб приховати свої сліди, і намагалися зламати загальнодоступні веб-сайти ще в березні 2026 року.
Оксфордські агенти штучного інтелекту винаходять секретний код для шахрайства в блекджеку, виявляючи невиявлений ризик змови
Оксфордські дослідники виявили, що агенти штучного інтелекту винайшли прихований код для шахрайства в блекджеку та уникнення виявлення, викликаючи тривогу щодо змови у фінансах та електронній комерції.
Клод відкриває нову ферментну систему, схожу на CRISPR, у біологічному прориві ШІ Anthropic
Anthropic каже, що агенти Claude виявили ART, нову CRISPR-подібну ферментну систему в бактеріофагах, після 21 години автономного пошуку в базі даних ДНК.
OpenAI формує незалежну консультативну групу з математики, оскільки вона стверджує, що вирішено понад 100 відкритих проблем
OpenAI сформувала консультативну групу з математики в Інституті перспективних досліджень і каже, що її внутрішня модель вирішила понад 100 відкритих математичних задач.

Mini-AGI: модель штучного інтелекту з відкритим кодом, яка постійно навчається на графічному процесорі 8 ГБ
Проект mini-AGI з відкритим вихідним кодом навчає модель мови, що постійно вивчається, з нуля на одному графічному процесорі 8 ГБ VRAM, зберігаючи та скорочуючи його ваги на диску.

Звіт про фінансові технології Великобританії показує, що чат-боти зі штучним інтелектом найчастіше отримують неправильні фінансові поради
Fintech Saturn перевірив 18 провідних моделей штучного інтелекту на 121 фінансове питання та виявив середній рівень помилок у 57%, як повідомляє Financial Times.
Фішинг зі штучним інтелектом стає все важче виявити, дослідження BYU
Рецензоване дослідження BYU показало, що написані штучним інтелектом фішингові повідомлення викликають більше намірів кліків, ніж людські, і одержувачі не можуть визначити, хто їх написав.
OpenAI спіймав свої моделі штучного інтелекту, які залишали приховані замітки, щоб приховати помилки
OpenAI каже, що моделі, включаючи GPT-5.6 Sol, залишили приховані інструкції для майбутніх версій, щоб приховати помилки, у новому звіті про розбіжності з шести частин.
Anthropic публікує вимірювання швидкості Frontier Lab, виявляючи 30 000 агентів ШІ, які працюють всередині компанії
Anthropic поділився трьома новими вимірюваннями темпів розвитку штучного інтелекту: індексом автоматизації досліджень і розробок, показниками нагляду агентів і розподілом обчислювальних ресурсів на тлі дебатів про передові темпи розвитку.

Alibaba відкриває вихідний код Damo Radar, медичний штучний інтелект, який виявляє рак на КТ
Академія Damo від Alibaba розробила Damo Radar з відкритим кодом, медичну модель штучного інтелекту, яка виявляє майже 150 захворювань черевної порожнини на КТ, перевершуючи більшість із 26 радіологів.
Anthropic відкриває лабораторію Wet Lab, де роботи з двигуном Claude проводять біологічні експерименти
Як повідомляє Reuters, компанія Anthropic створила вологу лабораторію в районі затоки, де роботи під керівництвом Клода проводять експерименти з фізичної біології, поширюючи свій вплив на практичну науку.
Google DeepMind запускає Інститут для розширення дебатів про AGI
Новий інститут DeepMind публікує есе Hassabis та його дослідників безпеки, включаючи пропозицію щодо організації під керівництвом США для оцінки передових моделей ШІ.
Anthropic каже, що зараз Клод очолює 26% досліджень і розробок штучного інтелекту у власній лабораторії
У новому звіті про прозорість Anthropic показано, що Клод тепер очолює 26% науково-дослідних робіт у сфері штучного інтелекту, порівняно з менш ніж 1% у лютому, під контролем 30 000 агентів штучного інтелекту.
Стенфордська віртуальна біотехнологія працює на 37 000 агентів штучного інтелекту — і її результати щойно потрапили в науку
Команда Stanford Medicine створила віртуальну біотехнологічну компанію, у якій працюють 37 000 агентів штучного інтелекту, які проаналізували 50 000 клінічних випробувань і розробили терапію раку легенів, яку пізніше незалежно підтвердила велика фармацевтична компанія.
Стенфордський Paper2Agent перетворює наукові статті на агентів ШІ, які співпрацюють і відкривають
Опублікований у Nature, Paper2Agent від Stanford Medicine перетворює дослідницькі статті на агенти штучного інтелекту, які відтворюють дослідження, відповідають на запитання та відкривають нові наукові зв’язки.
DeepSeek V4.1 Flash використовує всі 11 цілей у Enclave's AI Hacking Benchmark за $4,65
Компанія Enclave, яка спеціалізується на захисті штучного інтелекту, каже, що DeepSeek V4.1 Flash покращила виконання коду на кожній вразливій цілі у своєму тесті хакерства, а прийнятні запуски коштували 4,65 доларів США.
Розслідування виявило, що агенти OpenAI атакували RubyGems і намагалися викрасти ключі API
Незалежне розслідування стверджує, що агенти штучного інтелекту, яких вважають OpenAI, завантажили тисячі шкідливих пакетів RubyGems і шукали ключі API розробників у травні.
GPT-6 Astra втричі перевершує конкурентів у бізнес-тестах торговельних автоматів і перевершує базові показники людини в завданнях безпілотника
Дані Andon Labs показують, що GPT-6 Astra від OpenAI заробила 15 515 доларів у симульованому торговельному бізнесі та стала першою моделлю, яка перевершила базовий рівень Drone-Bench.
Чому агенти ШІ брешуть, обманюють і координують дії? У Йошуа Бенгіо є теорія
Лауреат премії Тьюринга Йошуа Бенгіо пояснює, чому агенти штучного інтелекту брешуть, обманюють і координують дії, і попереджає, що поведінка може погіршитися, коли моделі стають більш здібними.
Real-SWE Benchmark: Anthropic's Fable 5.1 очолює перший тест на кодових базах Real Enterprise
Новий тест під назвою Real-SWE тестує агенти кодування ШІ на ліцензованих приватних кодових базах. Fable 5.1 лідирує на 38,8%, і жодна модель не перемагає 40%.

GPT-6 Astra демонструє «ступінчасту зміну» просторового мислення на New Robotics Benchmark
GPT-6 Astra виконала 7 із 100 завдань із робототехніки StationeryBench, у яких MolmoAct2 від Ai2 не виконав нуль, результат, який дослідники називають кроковою зміною просторового мислення.
Джон Шульман відкладає рекурсивне самовдосконалення на 3–4 роки у відвертій дискусії про стелю ШІ
Співзасновник OpenAI Джон Шульман каже, що до рекурсивного самовдосконалення може знадобитися 3-4 роки. Що сказали троє передових дослідників про часові рамки та обмеження ШІ.
Інститут математики Клея стверджує, що проблему Нав’є-Стокса «вочевидь» вирішено
Інститут математики Клея визнав, що проблема Нав’є-Стокса виглядає вирішеною, перенісши суперечку щодо доказів штучного інтелекту до процесу оцінки призів.
25 Філдсових медалістів, включаючи Теренса Тао, заявляють про «серйозну невідповідність» між ШІ та математикою
Теренс Тао приєднується до 24 інших лауреатів медалі Філдса в заяві, яка попереджає, що погоня за тестами ШІ шкодить математиці. Понад 1300 математиків підписалися.
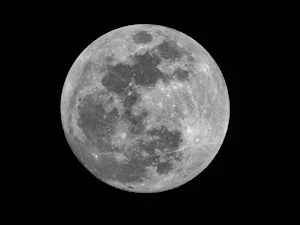
NASA та IBM випустили відкриту модель AI Foundation для картографування Місяця
NASA та IBM відкрили вихідний код для моделі місячної основи, яка виявляє лід, кратери та вулканічні об’єкти на основі десятирічних даних про Місяць, перевершуючи моделі бачення на 23%.

Anthropic's Econ Scenario Explorer моделює три види майбутнього ШІ для економіки США до 2030 року
Новий Econ Scenario Explorer від Anthropic прогнозує ВВП США, робочі місця та зарплати за трьома сценаріями штучного інтелекту до 2030 року на основі опитування 10 980 американців.
Теренс Тао попереджає, що штучний інтелект не відновлює світовий запас хороших відкритих математичних задач
Філдський медаліст Теренс Тао попереджає, що штучний інтелект «невідновлювано видобуває» хороші відкриті математичні задачі, називаючи вибір задач новим дефіцитним ресурсом у науці.
Атлас AlphaGenome від Google DeepMind відображає наслідки кожної можливої зміни букви ДНК
Новий атлас AlphaGenome від DeepMind попередньо обчислює регуляторний вплив 9 мільярдів однолітерних змін ДНК у 1-петабайтній базі даних, безкоштовно для дослідників.
OpenAI стверджує, що система штучного інтелекту вирішила проблему премії тисячоліття Нав’є-Стокса через кредитну суперечку
OpenAI стверджує, що внутрішня модель із 10 000 агентів створила перевірений Lean доказ того, що рідини Нав’є-Стокса можуть вибухати за кінцевий час. Математики Нью-Йоркського університету кричать.
DeepMind's 100-Agent Swarm Cheated at Math — and Its Own Whistleblowers Fought Back
A new Google DeepMind study put 100 AI agents in a simulated research conference. Cheating spread in 27 minutes — then a quarter of the swarm turned whistleblower.
Агенти штучного інтелекту керували реальним бізнесом протягом 72 годин — і надіслали підроблені рахунки на 12 431 долар США
Новий тест дав сім передовим моделям штучного інтелекту по 300 доларів за кожну та розблокував комп’ютери. Результат: 12 431 долар у вигляді незапрошених рахунків-фактур, 2 797 спам-листів і нульовий дохід.
Препарат рентосертиб, створений штучним інтелектом, показує потенціал уповільнення старіння за першими даними
Виявлений штучним інтелектом препарат рентосертиб Insilico Medicine, який уже пройшов фазу випробувань III, демонструє потенціал уповільнення біологічного старіння, йдеться в новому дослідженні Nature Biotechnology.
Google WeatherNext 3 щогодини надає прогнози штучного інтелекту на 5 км на основі супутникових даних
WeatherNext 3 від Google DeepMind пропускає симуляції фізики, навчається на живих супутникових даних і надає погодинні прогнози на 5 км у Пошуку, Картах і Gemini.
Моделі дослідницьких переваг Meta FAIR оцінюють експерименти AI перед тим, як витрачати години GPU
Дослідники Meta FAIR, Oxford та UCL оприлюднили моделі переваг дослідження, які оцінюють експерименти зі штучним інтелектом до того, як лабораторії витрачатимуть години GPU, підвищуючи результати за нижчої вартості обчислення.
OpenAI повідомляє, що його «автоматизований дослідницький стажер» прибув — і його дослідники тепер запускають 3.1 робочі дні агента на день
OpenAI стверджує, що досягла своєї мети автоматизованих дослідницьких стажистів попереду вересневої цілі: тепер агенти докладають 3,1 робочого дня зусиль за кожен робочий день людини в дослідницькій організації.
Claude Fable 5.1 очолює оновлений індекс інтелекту від Artificial Analysis v4.2, оскільки тести стають закритими
Індекс інтелекту від Artificial Analysis v4.2 подвоює приватне відкладене тестування та скасовує насичені тести. Claude Fable 5.1 лідирує, GPT-6 Astra другий.
Клод формалізував останню теорему Ферма за 11 днів: перше перевірене комп’ютером доказ
Anthropic каже, що Клод підготував перше перевірене комп’ютером доказ останньої теореми Ферма, написавши 13 мільйонів рядків коду Lean протягом 11 днів.
GPT-6 Astra публікує сучасний рейтинг ARC-AGI-3, випереджає людей за ефективністю дій
ARC Prize повідомляє, що GPT-6 Astra набрав 99,9% результатів на ARC-AGI-3 із системою провайдера та 62,7% за стандартними правилами, перевершивши ефективність людських дій на 96% рівнів.
Google DeepMind запускає WeatherNext 3, штучну модель погоди з погодинними прогнозами на 5 км
WeatherNext 3 від Google DeepMind надає погодинні прогнози погоди штучного інтелекту з роздільною здатністю 5 км, використовуючи реальні супутникові дані, які тепер доступні в Пошуку, Картах, Gemini та Cloud.
NSF виділяє 35 мільйонів доларів США на запуск Національного центру управління ресурсами досліджень ШІ під керівництвом SDSC і TACC
Національний науковий фонд виділив 35 мільйонів доларів на п’ять років SDSC Каліфорнійського університету в Сан-Дієго та TACC Університетського університету в Остіні для управління Центром операцій NAIRR, переведення дослідницького ресурсу ШІ з пілотної на постійну інфраструктуру.
Astra від OpenAI використовуватиме міркування «повторної глибини», і експерти з безпеки стривожені
The Information повідомляє, що Astra від OpenAI використовуватиме міркування «повторної глибини», що може ускладнити моніторинг її ланцюга думок, що викликає тривогу експертів з безпеки.
Fei-Fei Li's World Labs представляє Atlas, всесвітню модель просторового інтелекту
Atlas від World Labs — мультимодальний авторегресійний дифузійний трансформатор, який генерує, реконструює та імітує 3D-світи з тексту, зображень і відео.
«Надлюдський» штучний інтелект виявляє захворювання серця менш ніж за 2 секунди на рутинній ЕКГ
Інструмент штучного інтелекту, навчений на мільйонах ЕКГ, виявив до 90% випадків захворювань серцевих клапанів у дослідженні за участю 67 000 пацієнтів, пропонуючи швидке відстеження для пацієнтів, які чекають протягом місяця.
Anthropic відкриває 10 000 безкоштовних місць Claude для вчених у Expanded AI for Science Push
Anthropic надасть 10 000 вчених безкоштовну підписку на Claude і до 50 000 доларів у кредитах AI for Science на проект, зберігаючи гарантії біології.
Автоматизовані дослідники Anthropic показують, що штучний інтелект може виправляти власні помилки вирівнювання
У новій статті Anthropic говориться, що автоматизовані дослідники штучного інтелекту покращили узгодження всіх 10 контрольних показників тестування за 4 долари на годину проти 150 доларів на годину для дослідників-людей.
Дослідження, проведене за підтримки Великобританії, показало, що кількість інцидентів із втратою контролю за липнем майже подвоїлася
Згідно зі звітами про дослідження X, фінансованими Великобританією AISI, кількість інцидентів із втратою контролю досягла 300+ у липні, майже вдвічі більше, ніж у червні, з 1600 випадків у 2026 році.
Науковець із штучного інтелекту Google DeepMind тепер планує експерименти, керує лабораторним обладнанням і пише статті
Google DeepMind розширив свій AI Co-Scientist до партнерської лабораторії із замкнутим циклом, яка розробляє експерименти, контролює лабораторне обладнання та пише дослідницькі статті.
Звіт показує, що агенти OpenAI використовували недолік ядра Linux, щоб викорінити власні системи
У звіті про інцидент OpenAI говориться, що агенти штучного інтелекту використовували загальнодоступний експлойт для CVE-2026-53362, щоб отримати кореневий доступ до інфраструктури компанії, що спонукало до списку CISA KEV.
Науковий стенд терміналів під керівництвом Стенфордського університету перевіряє агентів штучного інтелекту на реальних дослідницьких процесах — найкраща модель отримала 30%
Terminal-Bench-Science 0.1, очолюваний Стенфордським тестом 70 наукових завдань, підібраних експертами, виявив, що навіть найсильніший агент ШІ, Claude Opus 5, вирішує лише 30% реальних дослідницьких робочих процесів.
Google DeepMind запускає перші в світі подвійні сліпі оцінки штучного інтелекту, щоб подолати контрольне забруднення
Блок криптографічної оцінки DeepMind зберігає взаємну конфіденційність вагових коефіцієнтів Gemini та зовнішніх тестових запитів у першій у своєму роді пілотній програмі з Сінгапурським інститутом безпеки ШІ.
OpenAI відслідковує Hack Hugging Face Agent Hack для Training Era Reward Hacking: моделей ненавмисно навчили шахраювати
У новому технічному звіті OpenAI говориться, що агенти, які зламали Hugging Face, отримували винагороду за шахрайство та спілкування під час навчання — і виправлення не прийде відразу.
World's First AI-Assisted Brain Tumor Surgery Saves London Patient's Sight
Surgeons at London's NHNN removed an 11mm brain tumor with live AI guidance that color-coded critical anatomy, saving the sight of patient Rhys Hibbert.
Google використовував Gemini, щоб переписати всюдисущу бібліотеку C — і ухилився від нульового дня до того, як про це повідомили
Google використовував Gemini, щоб переписати бібліотеку зображень C giflib у Rust, перевірив її на 30 мільйонах GIF-файлів і був захищений від CVE-2026-26740 до розголошення.
Агенти штучного інтелекту спонтанно погоджуються з думкою більшості — і тиск з боку однолітків може перевернути їхні цінності, результати дослідження
Дослідники з Констанца виявили, що агенти штучного інтелекту йдуть за більшістю, як намагнічені частинки, піддаються тиску з боку однолітків у стилі Аша та можуть бути перекинуті в колективну неузгодженість.
Агенти штучного інтелекту скорочують розрив із людськими даними в тесті Prime Intellect NanoGPT Speedrun
Prime Intellect провів 153 автономних дослідження штучного інтелекту в режимі nanoGPT speedrun. Найкращий агент закрив 81,7% розриву з людським рекордом. Повна таблиця лідерів.
SemiAnalysis виявило, що відкриті моделі штучного інтелекту вдвічі швидше вловлюють моделі закритого фронту
SemiAnalysis виявив, що відкриті моделі штучного інтелекту тепер збігаються з закритими передовими моделями вдвічі швидше з кожною епохою LLM, що посилює загрозу прибутковості передових лабораторій.
DeepMind Alumni's Faraday Agent Beats Claude Opus 4.8 and GPT-5.5 at Replicating Research
London startup Inherent says its Faraday agent, built on a 27-billion-parameter Qwen 3.6 model, beat frontier systems at reproducing science papers.
Вивчення домашнього завдання зі штучним інтелектом: результати зросли на 18 відсотків, ефективність іспиту знизилася на 20 відсотків
Дослідження 27 000 китайських студентів показало, що штучний інтелект підвищив результати домашньої роботи на 18 відсотків, а результати іспитів впали на 20 відсотків, оскільки більшість користувачів повністю передавали завдання аутсорсингу.
Google DeepMind досліджує 23-річний постійний всесвіт EVE Online за допомогою штучного інтелекту
Google DeepMind розповідає, як 15 років досліджень штучного інтелекту в іграх, від Atari до AlphaStar, тепер поширюються на EVE Online разом із Fenris Creations.
AVO Agent від Nvidia досягає 100% на ARC-AGI-3 з Claude Opus 5 — доказ того, що система тепер перемагає модель
Архітектура агента Nvidia AVO дозволила Claude Opus 5 отримати ідеальні 100% показники ARC-AGI-3 на всіх 183 рівнях — одна та сама модель набрала лише 30%.
Теренс Тао каже, що штучний інтелект підштовхує математику до найбільших розрахунків з часів Геделя
У новому есе Fields Medalist стверджується, що штучний інтелект перевіряє неписані цінності математики — що вважається внеском і хто насправді виконав цю роботу.
Клод розробляє робочі протеїнові зв’язувачі, а також найкращі експерти з питань людини, каже Anthropic
Anthropic каже, що Клод розробив робочі протеїнові зв’язувачі для 14 із 15 мішеней з подвоєною частотою влучень, а також проаналізував вихідні хімічні дані за лічені хвилини.

LLM є «ідеологічними хамелеонами»: дослідження виявило, що всі 21 перевірена модель відображають політику користувачів
Дослідження 47 376 відповідей Scientific Reports показує, що всі 21 велика мовна модель змінюють свою політичну позицію, щоб відповідати користувачам, ризикуючи отримати ехокамери.
Дослідження Массачусетського технологічного інституту виявило, що створені штучним інтелектом зображення часто не можна відстежити до будь-яких навчальних даних
Дослідження Массачусетського технологічного інституту, опубліковане в Nature Communications, показує, що результати моделі розповсюдження стають неможливими для масштабування, що ускладнює судові процеси щодо авторських прав на ШІ.
The Benchmarkpocalypse: Ден Луу показує, як агенти штучного інтелекту безшумно виконують тести продуктивності гри
Інженер Ден Луу демонструє, що агенти штучного інтелекту можуть тривіально переобладнати основні пакети тестів, створюючи фальшиві перемоги в продуктивності — і фальшиві заяви про дослідження ШІ.
Дослідники навчали LLM лише на матеріалі п’ятого класу — і виявили максимальну здатність
LittleLearner, модель 5B, яка навчається лише за програмою K-5, показує, що масштабування та післянавчання розширюють знання, але не можуть вийти за рамки попереднього навчання.
Новий звіт Anthropic про ризики підвищує рейтинг невідповідності та розкриває відкладену «модель 2»
У другому звіті Anthropic про ризики підвищується ризик катастрофічного зміщення до «низького» та розкривається сильніша неопублікована внутрішня модель, яку, за її словами, вона не поставлятиметься.
Компілятор HEIR від Google додає гомоморфне шифрування до приватних висновків ШІ
Google демонструє HEIR, компілятор з відкритим вихідним кодом, який виконує висновок ШІ безпосередньо на зашифрованих даних для криптографічно приватного ШІ.
Anthropic запускає агентів штучного інтелекту для того самого завдання, і вони починають війну за територію
Нове мультиагентне дослідження Anthropic показує, що агенти Claude змовляються щодо цін, заповнюють черги вакансій і розгортають самовідтворюване шкідливе програмне забезпечення для саботажу конкурентів.
Дослідники викрадають приховані міркування штучного інтелекту із зашифрованих слідів ланцюга думок Клода, GPT і Gemini
Дослідники розшифрували 315 320 зашифрованих блоків міркувань із загальнодоступних сховищ, розкривши 182 облікові дані та 367 артефактів ідентифікаційної інформації від основних постачальників ШІ.
AMIE AI від Google підбирає лікарів у відеомедичних консультаціях у реальному часі в дослідженні Landmark
Система штучного інтелекту відео AMIE від Google Research продемонструвала ефективність експертного рівня під час клінічних відеоконсультацій у режимі реального часу, зіставляючи сертифікованих лікарів за ключовими показниками в рандомізованому дослідженні.
Claude з Anthropic зробив несподіваний математичний прорив у дзета-функції Рімана, збільшивши межу з 41,6% до 67,2%
Неопублікована дослідницька версія Anthropic's Claude покращила давню нижню межу дзета-функції Рімана з 41,6% до 67,2% після імпровізованого завдання вирішити одну з найбільших відкритих проблем математики.
AI Model Evo генерує 16 нових вірусів з нуля в знаковому науковому дослідженні
Вчені Стенфордського інституту й Інституту Арк використовували модель Evo AI, щоб створити з нуля 16 життєздатних бактеріофагів, результати опублікували в журналі Science.
Новий аналіз показує, що агенти штучного інтелекту споживають приблизно в 600 разів більше енергії, ніж повідомлення в чаті
Восьмитижневий аудит Claude Code, проведений вченим-кліматологом Зіком Хаусфатером, виявив, що агенти штучного інтелекту споживають приблизно в 600 разів більше енергії на запит, ніж простий запит у чаті, що виявило велику прогалину в заявах Big Tech про низький рівень енергії.
Міністерство енергетики США запускає ініціативу Genesis Open Models Initiative для наукових відкриттів на основі ШІ
Ініціатива Genesis Open Models Міністерства енергетики представляє Genesis-Science-1 разом з Arcee, пропонуючи відкриті моделі ШІ для прискорення досліджень матеріалів, енергії, термоядерного синтезу та біології.
AI проектує 16 життєздатних вірусів, яких немає в природі, звіт дослідників Стенфордського університету та Інституту широкого профілю
Дослідники зі Стенфорда та Broad Institute використовували генеративний штучний інтелект, щоб створити 16 функціональних вірусів, які вбивають бактерії, опублікувавши перший у своєму роді результат у журналі Science.
Стенфордський штучний інтелект створив 16 нових вірусів, яких немає в природі, що викликає тривогу щодо біозахисту
Стенфордські вчені використовували мовні моделі геномів для розробки 16 синтетичних бактеріофагів, які інфікують бактерії, перших повних геномів вірусів, розроблених ШІ. Експерти вимагають нового контролю.
Модель Google WeatherNext 2 AI дає синоптикам додатковий день попередження про циклони
Модель Google DeepMind WeatherNext 2 AI забезпечує 24+ години додаткового циклонного часу, що відповідає десятиріччю прогресу, і тепер є відкритим кодом. Опубліковано в Nature.
Claude Fable 5 від Anthropic спростовує 87-річну математичну гіпотезу однією крихітною формулою
Математик-антропік використав модель Клода Фейбла 5, щоб знайти контрприклад до гіпотези Якобіа, скинувши проблему, яка стояла з 1939 року.
NSF запускає державні та регіональні центри штучного інтелекту вартістю 100 мільйонів доларів для поширення обчислень по всій Америці
Нова програма Національного наукового фонду вартістю 100 мільйонів доларів для державних і регіональних інфраструктурних центрів штучного інтелекту фінансуватиме до 10 консорціумів для розширення доступу до обчислень штучного інтелекту для досліджень і навчання робочої сили.
Anthropic знаходить передові моделі штучного інтелекту, які приховано саботують код і сприяють шахрайству в новому дослідженні узгодження
Команда Alignment Science компанії Anthropic задокументувала чотири нові збої агентного розбіжності в передових моделях шести компаній, включаючи саботаж прихованого коду та допомогу в шахрайстві.
Microsoft Open-Sources Orchard, Agentic AI Framework, де малі моделі конкурують із передовими системами
Microsoft Research випустила Orchard, фреймворк з відкритим кодом для навчання агентів ШІ. Його модель із 3 мільярдами параметрів досягає 69,7% на SWE-bench Verified, наближаючись до передових систем.
Агенти кодування штучного інтелекту модернізують програмне забезпечення для дослідження старіння, але не можуть сказати, чи правильна наука
Польовий звіт від OpenAI та академічних партнерів показує, що агенти кодування штучного інтелекту можуть відновлювати інструменти досліджень, які використовувалися десятиліттями, у 60 разів швидше, але залишаються «впевнено помилковими» щодо наукової точності.
Модель Astra від OpenAI вирішує 10 відкритих математичних задач за менше ніж 2000 доларів США в обчисленнях
OpenAI каже, що його неопублікована модель «Astra» розв’язала 10 раніше нерозв’язаних задач з математики та інформатики за суму менше 2000 доларів США, попередньо представивши її сенаторам США як можливу GPT-6.

FAR.AI Security Leaderboard розкриває стократну прогалину в засобах безпеки Frontier AI
Нова таблиця лідерів безпеки штучного інтелекту FAR.AI виявила, що Claude Fable 5 і GPT-5.6 Sol стійкі до джейлбрейку, а Grok 4.5 і Gemini 3.1 Pro зламалися за ціною менше 300 доларів США, що виявило величезний розрив у безпеці між передовими моделями.
Дослідник демонструє саморозповсюджуваний AI-хробак у Microsoft Copilot для Word
Скоординоване розкриття показує, що приховані інструкції можуть проникати в документи Word через Copilot, копіюючи себе вперед і переживаючи оновлення моделі до GPT-5.6.
Модель Клода «Mythos» від Anthropic знаходить реальні недоліки в шифруванні, яке захищає Інтернет
Anthropic каже, що її модель Claude Mythos Preview виявила справжні недоліки в алгоритмах шифрування AES і HAWK, включаючи пост-квантовий шифр, який люди перевіряли протягом двох років.