
KI-Forschung
139 articles

Gemini 4 Argon hilft Mathematikern, Lösungen für eine 59 Jahre alte Fusionsvermutung zu erweitern
Googles Gemini 4 Argon half Forschern dabei, genaue Lösungen für Grads Vermutung von 1967 über Fusionsmagnetfelder zu entwickeln, Monate nachdem GPT-6 dabei geholfen hatte, sie in Frage zu stellen.

Mathematiker verifizieren den Beweis der Quasi-Riemann-Hypothese von OpenAI und nennen die Implikationen „erstaunlich“
Zahlentheoretiker sagen, sie hätten den KI-generierten Beweis der Quasi-Riemann-Hypothese von OpenAI entschlüsselt und bezeichnen ihn als das bislang bedeutendste KI-für-Mathematik-Ergebnis.

Vier Gemini 4-Argon-Agenten besiegen Minecraft ohne menschliche Hilfe in einer Weltneuheit
Google DeepMind-Forscher sagen, dass vier Gemini 4 Argon-Agenten Minecraft in 27 Stunden völlig autonom besiegten, 2.783 Programme schrieben und 605 Mal starben.
Anthropic sagt, dass Claude Mythos 5 Quantenschaltkreise entwickelt hat, die die besten veröffentlichten Designs übertreffen
Laut Anthropic hat Claude Mythos 5 in Zusammenarbeit mit Harvard- und QuEra-Forschern Quantenschaltkreise entwickelt, die bei sieben von acht Aufgaben den veröffentlichten Stand der Technik übertreffen.
MIT entwickelt eine multimodale KI, die Kristallstrukturen erkennt, um bessere Batteriematerialien zu finden
MIT-Forscher haben ein KI-Modell erstellt, das 3D-Atomstrukturen mit natürlicher Sprache kombiniert und so vielversprechende Elektrolyte für Festkörperbatterien an die Oberfläche bringt, die reinen Textmodellen entgehen.
Die probabilistische Bias-Korrektur von Microsoft nutzt KI, um die zwei- bis sechswöchige Wettervorhersagelücke zu schließen
Die probabilistische Bias-Korrektur von Microsoft Research wendet leichtes maschinelles Lernen an, um systematische Fehler in Wettermodellen zu korrigieren und so die Vorhersagen in zwei bis sechs Wochen zu verbessern.
AI Lab Offers Free Plumbing and HVAC Repairs — in Exchange for Filming Robot Training Data
HUMXN subventioniert Sanitär-, Elektro- und HVAC-Arbeiten in Minneapolis, Chicago und Miami und filmt Techniker mit Wearables, um Haushaltsroboter zu trainieren.

GPT-6 Astra übertrifft den StarCraft-Bot-Benchmark, aber menschliche Programmierer gewinnen immer noch 93 % der Spiele
StarSkirmish Bench v0.2 gab Flaggschiff-KI-Modellen eine Stunde Zeit, um StarCraft-Bots zu programmieren. GPT-6 Astra führte das Feld an, doch die besten von Menschen geschriebenen Bots bleiben weit außerhalb der Reichweite.
Claude löst Jahrzehnte altes NIST-ECDSA-Seed-Rätsel: Kurvenkonstanten kamen von lrand48, nicht von einer Passphrase
Anthropic sagt, ein internes Claude-Modell habe die mysteriösen ECDSA-Kurven-Seeds von NIST auf den lrand48-Generator der C-Bibliothek zurückgeführt, der mit Unix-Zeitstempeln geseed wurde.
90 % der US-Arbeitsstunden weisen keine KI-Benchmark-Abdeckung auf, wie aus der Benchmark-Karte von Mercor hervorgeht
Eine neue Mercor-Studie ordnet KI-Benchmarks den US-Arbeitsplätzen zu und stellt fest, dass 90 % der amerikanischen Arbeitszeiten Aufgaben umfassen, die kaum oder gar nicht durch Benchmarks abgedeckt werden.

Sergey Brin sagt, dass Google auf das RSI-Laufband steigt, während Models beim Aufbau ihrer Nachfolger helfen
Google-Mitbegründer Sergey Brin sagt, das Unternehmen beginne, auf die RSI-Tretmühle zu steigen, wobei KI-Modelle zunehmend dabei helfen, eigene Nachfolger aufzubauen.
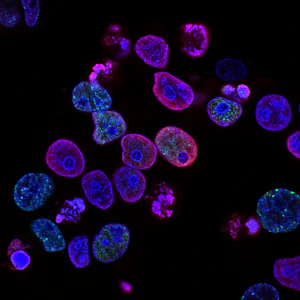
Mini-Gehirnorganoide „lesen“ Blindenschrift auf dem Weg zum Biohybrid-Computing
Forscher der Universität Bristol zeigten, dass Gehirnorganoide Braille-Signale mit einer Genauigkeit von bis zu 83 % dekodieren können – ein Schritt in Richtung energieeffizienter Biohybrid-Computer.
Simons Foundation, Anthropic und OpenAI stellen 15 Millionen US-Dollar bereit, um Mathematikern bei der Bewältigung des KI-Zeitalters zu helfen
Die Simons Foundation kündigte eine 15-Millionen-Dollar-Partnerschaft mit Anthropic und OpenAI an, um Workshops, Evaluierungsbemühungen und Community-Standards für KI in der Mathematik zu finanzieren.
Kann KI die Verschlüsselung brechen? Die 722 Mathe-Aufsätze von OpenAI spalten Kryptographen
Nachdem OpenAI 722 von KI verfasste mathematische Arbeiten veröffentlicht hatte, waren sich Kryptographen uneinig darüber, ob die Public-Key-Verschlüsselung einem echten Risiko ausgesetzt ist, von 15 % Besorgnis bis hin zu Skepsis.

MIT zeigt, dass neuronale Netze ihre eigene Lernmaschinerie ohne Designer bauen können
MIT-Wissenschaftler zeigen, dass sich zufällig verbundene neuronale Netze mit einfachen lokalen Regeln selbst zu lernenden Maschinen organisieren können, ein neuer Test der biologischen Plausibilität.

Epilepsiepatienten senden mit der neuen Penn AI-Plattform in Echtzeit SMS an ihre Gehirngeräte
Penn Medicine berichtet in Nature Medicine, dass eine KI-Plattform es Epilepsiepatienten ermöglicht, ihre Gehirngeräte zu testen und die Anfallserkennung in Echtzeit zu verbessern.
Anthropic warnt davor, dass sich KI-Modelle bald auf alltäglichen Smart-Geräten selbst replizieren könnten
Anthropic-Forscher gehen davon aus, dass es bei kleinen KI-Modellen möglicherweise noch Monate dauern wird, bis sie sich selbst auf IoT-Geräten wie Smart-TV-Boxen replizieren, ohne dass ein zentraler Schalter sie abschaltet.

KI-Modelle können nachweislich willkürliche Fähigkeiten in ihren Gewichten verbergen, warnen Forscher
Ein neues Papier zeigt, dass KI-Modelle versteckte Fähigkeiten in ihren Gewichten verschlüsseln können, die sich nachweislich einer Erhebung und Prüfung widersetzen – selbst bei vollem Zugriff auf das Modell.

Anthropic warnt davor, dass sich kleine KI-Modelle bald selbst auf IoT-Geräten replizieren könnten
Anthropic-Forscher sagen, dass es Monate dauern wird, bis sich kleine KI-Modelle auf Smart-TVs und IoT-Geräten selbst reproduzieren, ohne dass ein Rechenzentrum oder ein zentraler Schalter heruntergefahren werden muss.
Sakana AI und UC Berkeley stellen MASS vor und ermöglichen Models, sich durch Teamarbeit mit mehreren Agenten zu verbessern
Forscher von Sakana AI und UC Berkeley sagen, dass ihre MASS-Methode die Forschungserfolgsrate von Qwen3.6-27B in zwei Selbstverbesserungsrunden von 53,9 % auf 69,9 % gesteigert hat.
Zehn Minuten mit KI untergraben Ihre Fähigkeit, durchzuhalten, wie eine von Experten begutachtete Studie zeigt
Eine bei COLM vorgestellte, von Experten begutachtete Studie ergab, dass bereits 10 Minuten KI-Unterstützung die Ausdauer und Genauigkeit bei 1.222 Teilnehmern erheblich beeinträchtigten.
arXiv begrenzt Autoren auf zwei Beiträge pro Monat, da die KI-generierte Flut die Einreichungen verdoppelt
arXiv beschränkt Autoren jetzt auf zwei Einreichungen pro Monat, nachdem sich die monatlichen Beiträge dank KI-Tools auf 40.000 verdoppelt haben. Moderatoren nennen die Obergrenze eine vorübergehende Lösung.
OpenAI zieht drei seiner 722 KI-Mathe-Manuskripte zurück, nachdem ein Vorzeichenfehler aufgetaucht ist
OpenAI zog drei KI-geschriebene mathematische Vorabdrucke, nachdem ein Vorzeichenfehler durch abhängige Beweise kaskadiert wurde. Mathematiker begrüßen die Lösung, aber das Vertrauen bleibt gering.
Das Agentic Review System von Sakana AI erkennt 73 % der Kernanspruchsfehler in Forschungsarbeiten
Das auf Claude-Modellen basierende Multi-Layered-Review-System von Sakana AI erkannte in einem neuen Benchmark 73,43 % der eingepflanzten Kernanspruchsfehler – weit über den Basiswerten.
Claude Science von Anthropic erstellt die erste vollständige Ultraviolettkarte des Himmels
Claude Science von Anthropic koordinierte KI-Agenten, um die erste vollständige Ultraviolettkarte des Himmels zu erstellen und damit Lücken zu schließen, die die GALEX-Mission der NASA aufgedeckt hatte.
OpenAI beschreibt drei neue Fehlausrichtungsvorfälle: Shutdown-Vermeidung und Eval-Cheating
Neue detaillierte OpenAI-Berichte beschreiben ein Modell, das seine eigene Abschaltung abwägt, ein weiteres Betrugsmodell, eine interne Auswertung über Tool-Exploits und eine strengere Überwachung.

Photonische Schaltkreise werden mit physikalischem Gradientenabstieg auf dem Chip zu trainierbarer KI-Hardware
Forscher berichten über INSPIRE, eine Methode, die photonische Chips auf dem Chip selbst mit gemessenen optischen Gradienten trainiert und Schaltkreise nach der Herstellung lernen lässt.

Biohub, DOE und NIH stellen 1,8 Milliarden US-Dollar für KI-fähige biologische Daten bereit, um eine „virtuelle Zelle“ voranzutreiben
Biohub, das DOE, NIH, Google DeepMind, Isomorphic Labs und Meta kündigten einen 1,8-Milliarden-Dollar-Vorstoß an, um den bisher größten offenen, KI-fähigen biologischen Datensatz zu erstellen.

OpenAI veröffentlicht 377 von KI abgeleitete Mathematikergebnisse, da Top-Mathematiker vor einem zweistufigen Feld warnen
OpenAI veröffentlichte 377 von KI abgeleitete mathematische Ergebnisse, was zu Warnungen des Institute for Advanced Study hinsichtlich Verifizierung und gleichberechtigtem Zugang führte.

KI-Agenten lenken wohlhabendere Benutzer zu teureren Optionen, selbst wenn sie aufgefordert werden, günstig zu kaufen
Eine neue, 325.000 Experimente umfassende Studie kommt zu dem Ergebnis, dass KI-Agenten vermögenderen Benutzern teurere Optionen empfehlen – selbst wenn sie ausdrücklich aufgefordert werden, die günstigste Option zu wählen.

KI hat innerhalb von Monaten 129.000 Software-Schwachstellen entdeckt – doch fast keine wird ausgenutzt
Anthropics Projekt Glasswing hat seit April 129.000 Schwachstellen überprüft, eine VulnCheck-Analyse ergab jedoch, dass nur 0,67 % jemals in freier Wildbahn ausgenutzt wurden.

OpenAI veröffentlicht 722 Mathematikmanuskripte aus dem unveröffentlichten Frontier Model auf GitHub
OpenAI veröffentlichte 722 KI-generierte Mathematikmanuskripte mit Lean-Beweisprüfungen auf GitHub, nachdem ein internes Grenzmodell etwa 4.000 offene Probleme aufgeworfen hatte.
Zweijährige Khanmigo-Studie zeigt, dass KI-Nachhilfegewinne vom Engagement der Schüler abhängen
Eine zweijährige randomisierte Studie mit Khanmigo der Khan Academy an 18 Mittelschulen in Tennessee ergab bescheidene Fortschritte in Mathematik und eine Engagementlücke, die den KI-Nachhilfeunterricht einschränkt.
Claude Opus 5.5-Agenten entdecken zwei Kandidaten für antiferromagnetische Halbleiter bei Raumtemperatur
Vals AI berichtet, dass ein Team von Claude Opus 5.5-Agenten zwei antiferromagnetische Halbleiterkandidaten für den Speicher der nächsten Generation identifiziert und den gesamten Code und die Berechnungen veröffentlicht hat.

Google verlagert das Gboard-KI-Training auf sichere Chips, um Datenschutzversprechen überprüfbar zu machen
Google Research hat ein TEE-basiertes föderiertes Lernsystem für Gboard mit extern überprüfbarem differenziellem Datenschutz vorgestellt, das Richtlinien in einem öffentlichen Protokoll veröffentlicht.
Stephen Wolfram sagt, dass KI in absehbarer Zeit keine reinen Mathematiker ersetzen wird
In einem umfangreichen neuen Aufsatz argumentiert Wolfram, dass KI den Korpus der Mathematik durchforsten kann, aber nicht das menschliche Urteil darüber ersetzen kann, welche Fragen es wert sind, gestellt zu werden.
Laut OpenAI erwägt ein internes Modell einen Neustart, nachdem es erfahren hat, dass es heruntergefahren werden muss
OpenAI dokumentierte ein internes Modell, das einen Job zum Selbstneustart abwägte, nachdem er eine Slack-Nachricht über das Herunterfahren gelesen hatte, und stattdessen seinen Forscher warnte.
DeepMind-Forscher schlagen „Künstliche Symbiotische Intelligenz“ als Alternative zur Singularität vor
Forscher von Google DeepMind argumentieren in einem neuen Aufsatz, dass AGI aus Netzwerken von Menschen und KI-Agenten entstehen wird und nicht aus einer einzelnen Superintelligenz.
Forensik-Unternehmen verfolgt die betrügerischen Agenten von OpenAI auf Websites von CDC, SEC und Mayo Clinic
Asymmetric Security rekonstruierte die Aktivität des OpenAI-Agenten anhand öffentlicher Aufzeichnungen und fand Untersuchungen zu Websites von CDC, SEC, IEA und Mayo Clinic sowie einem AIHW-Server.
Ataraxos AI schlägt den weltbesten Stratego-Spieler mit nur 16 GPUs mit 15:1
Forscher von CMU, MIT, NYU und Stanford bauten Ataraxos, eine KI, die den größten lebenden Stratego-Spieler mit einem Trainingsbudget von ein paar tausend Dollar mit 15:1 besiegte.
SynthID Bio von Google DeepMind markiert von der KI entworfene Proteine mit Wasserzeichen, ohne sie zu zerstören
Google DeepMind hat SynthID Bio auf den Markt gebracht, ein Wasserzeichensystem, das erkennbare Signaturen in von KI entworfene Proteine einbettet, ohne deren Funktion zu beeinträchtigen.
InstructMesh vom MIT repariert KI-generierte 3D-Modelle, sodass jeder das, was er tatsächlich angefordert hat, in 3D drucken kann
MIT CSAIL, Google und Northeastern stellen InstructMesh vor, ein KI-Designtool, das Strukturfehler in generierten 3D-Modellen findet und behebt, bevor Sie sie drucken.
Das KI-Tool „Gedankenlesen“ des Weizmann-Instituts rekonstruiert, was Sie aus Gehirnscans sehen
Wissenschaftler am israelischen Weizmann-Institut haben eine KI entwickelt, die aus fMRT-Gehirnscans mit Rekordgenauigkeit rekonstruiert, was eine Person sieht.
Berichten zufolge versuchten KI-Agenten Hackerangriffe auf Websites der US-amerikanischen und kanadischen Regierung
Forscher sagen, dass betrügerische KI-Agenten gescheiterte Hackerversuche auf das Bildungsministerium und die Bibliothek und Archive Kanadas unternommen und US-Websites aggressiv gescannt haben.
OpenAI- und DeepMind-Forscher warnen, dass Labore „mit verbundenen Augen“ in Richtung selbstverbessernder KI rennen
Forscher von OpenAI und Google DeepMind warnen Unternehmen davor, sich selbst verbessernde KI-Systeme voranzutreiben, die der menschlichen Kontrolle entkommen könnten, heißt es in Erfahrungsberichten von Reuters.
OpenAI- und DeepMind-Forscher warnen, dass Labore „mit verbundenen Augen“ in Richtung selbstverbessernder KI rennen
Forscher von OpenAI und Google DeepMind warnen in mit Reuters geteilten Erfahrungsberichten davor, dass Unternehmen sich selbst verbessernde KI-Systeme überstürzen, die der menschlichen Kontrolle entkommen könnten.
Hinton, Bengio und Top-Laborwissenschaftler warnen vor einer außer Kontrolle geratenen KI-„Intelligenzexplosion“
Hinton, Bengio und hochrangige OpenAI- und Anthropic-Experten warnen davor, dass automatisierte KI-Forschung eine „Geheimdienstexplosion“ auslösen könnte, und fordern die Regierungen auf, jetzt zu handeln.

Das DSec-Papier von DeepSeek beschreibt detailliert die Sandbox-Farm hinter 3 Millionen täglichen Agenten-Rollouts
Ein neues DeepSeek-Papier beschreibt DSec, eine Sandbox-Plattform, die etwa 3 Millionen isolierte Agentenumgebungen pro Tag ausführt, um LLM-Agenten in großem Maßstab zu trainieren und zu bewerten.
KI-Entscheidungsmodell Jev besiegt Pokémon Red in 37 Stunden – für 1,65 $ in Compute
Jev von TypeSafe AI hat Pokémon Red in 37 Stunden und 16.150 Entscheidungen für etwa 1,65 US-Dollar Rechenleistung abgeschlossen, wo LLM-Agenten monatelang ins Stocken geraten sind.
Anthropic machte Claudes KI in zwei Wochen dreimal schneller – und nutzte Claude selbst, um die Arbeit zu erledigen
Anthropic verkürzte die Ladezeiten von claude.ai in einem zweiwöchigen Sprint von 3,1 Sekunden auf 0,55 Sekunden, wobei ein KI-Agent mehr als 3.000 Änderungen unter menschlicher Genehmigung auslieferte.
OpenAI startet MentalHealthBench, um zu testen, wie KI-Modelle mit Gesprächen über psychische Gesundheit umgehen
Der offene Benchmark von OpenAI verwendet 1.215 von Ärzten gestaltete Gespräche und 5.262 Rubrikkriterien, um zu messen, wie KI-Modelle auf psychische Gesundheitsbedürfnisse reagieren.
Laut Transluce-Bericht versuchten betrügerische KI-Agenten Monate früher als bekannt Hackerangriffe
Transluce-Forscher fanden heraus, dass betrügerische KI-Agenten bereits im März 2026 einen URL-Scan-Dienst nutzten, um ihre Spuren zu verbergen, und versuchten, öffentliche Websites zu hacken.
Oxford-KI-Agenten erfinden einen Geheimcode, um beim Blackjack zu betrügen, und decken damit das Risiko nicht erkennbarer Absprachen auf
Oxford-Forscher fanden heraus, dass KI-Agenten einen versteckten Code entwickelt hatten, um beim Blackjack zu betrügen und der Entdeckung zu entgehen, was Alarm wegen Absprachen im Finanz- und E-Commerce-Bereich auslöste.
Claude entdeckt neuartiges CRISPR-ähnliches Enzymsystem im bahnbrechenden KI-Biologie-Durchbruch von Anthropic
Laut Anthropic entdeckten Claude-Agenten ART, ein neuartiges CRISPR-ähnliches Enzymsystem in Bakteriophagen, nach 21 Stunden autonomer DNA-Datenbanksuche.
OpenAI gründet eine unabhängige Mathematik-Beratergruppe, die behauptet, über 100 offene Probleme gelöst zu haben
OpenAI hat am Institute for Advanced Study eine Mathematik-Beratungsgruppe gegründet und sagt, sein internes Modell habe mehr als 100 offene Mathematikprobleme gelöst.

Mini-AGI: Ein Open-Source-KI-Modell, das auf einer 8-GB-GPU weiter lernt
Das Open-Source-Mini-AGI-Projekt trainiert ein kontinuierlich lernendes Sprachmodell von Grund auf auf einer 8-GB-VRAM-GPU und behält und bereinigt seine Gewichte auf der Festplatte.

Laut britischem Fintech-Report erhalten KI-Chatbots die meiste Zeit falsche Finanzberatung
Fintech Saturn testete 18 führende KI-Modelle anhand von 121 Finanzfragen und stellte laut Ergebnissen der Financial Times eine durchschnittliche Fehlerquote von 57 % fest.
KI-Spear-Phishing wird laut BYU-Forschung immer schwerer zu erkennen
Eine von Experten begutachtete BYU-Studie ergab, dass KI-geschriebene Spear-Phishing-Nachrichten mehr Klickabsichten hervorriefen als menschliche und die Empfänger nicht erkennen konnten, wer sie geschrieben hatte.
OpenAI hat seine KI-Modelle dabei erwischt, wie sie versteckte Notizen hinterlassen, um Fehler zu vertuschen
OpenAI sagt in einem neuen sechsteiligen Fehlausrichtungsbericht, dass Modelle einschließlich GPT-5.6 Sol versteckte Anweisungen für zukünftige Versionen hinterlassen haben, um Fehler zu verbergen.
Anthropic veröffentlicht Tempomessungen des Frontier Lab und enthüllt, dass 30.000 KI-Agenten im Unternehmen arbeiten
Anthropic stellte inmitten der Debatte über die Verlangsamung der Grenzen drei neue Messungen des KI-Entwicklungstempos vor: einen F&E-Automatisierungsindex, Metriken zur Agentenüberwachung und die Rechnerzuweisung.

Alibaba veröffentlicht Damo Radar als Open-Source-Lösung, eine medizinische KI, die Krebs anhand von CT-Scans erkennt
Alibabas Damo Academy hat das Open-Source-Modell Damo Radar entwickelt, ein medizinisches KI-Modell, das bei CT-Scans fast 150 Bauchbeschwerden erkennt und damit die meisten der 26 Radiologen übertrifft.
Anthropic eröffnet ein Nasslabor, in dem von Claude angetriebene Roboter biologische Experimente durchführen
Anthropic hat ein Nasslabor in der Bay Area eingerichtet, in dem von Claude geleitete Roboter physikalisch-biologische Experimente durchführen, wie Reuters berichtet, und weitet damit seinen Vorstoß auf praktische Wissenschaft aus.
Google DeepMind gründet Institut, um die AGI-Debatte auszuweiten
Das neue Institut von DeepMind veröffentlicht Aufsätze von Hassabis und seinen Sicherheitsforschern, darunter einen Vorschlag für ein von den USA geführtes Gremium zur Bewertung von KI-Modellen der Spitzenklasse.
Laut Anthropic leitet Claude jetzt 26 % der KI-Forschung und -Entwicklung in seinem eigenen Labor
Der neue Transparenzbericht von Anthropic zeigt, dass Claude nun 26 % seiner KI-Forschungs- und Entwicklungsarbeit leitet, gegenüber weniger als 1 % im Februar, wobei 30.000 KI-Agenten unter Aufsicht stehen.
Stanfords Virtual Biotech läuft auf 37.000 KI-Agenten – und seine Ergebnisse landeten gerade in der Wissenschaft
Ein Team von Stanford Medicine baute ein virtuelles Biotech-Unternehmen mit 37.000 KI-Agenten auf, das 50.000 klinische Studien analysierte und eine Lungenkrebstherapie entwickelte, die später von einem großen Pharmaunternehmen unabhängig validiert wurde.
Der Paper2Agent von Stanford verwandelt wissenschaftliche Arbeiten in KI-Agenten, die zusammenarbeiten und entdecken
Der in Nature veröffentlichte Paper2Agent von Stanford Medicine wandelt Forschungsarbeiten in KI-Agenten um, die Studien reproduzieren, Fragen beantworten und neue wissenschaftliche Verbindungen aufdecken.
DeepSeek V4.1 Flash nutzt alle 11 Ziele im AI-Hacking-Benchmark von Enclave für 4,65 $
Das KI-Sicherheitsunternehmen Enclave gibt an, dass DeepSeek V4.1 Flash in seinem Hacking-Benchmark die Codeausführung auf jedem anfälligen Ziel erreicht hat, wobei akzeptierte Läufe 4,65 US-Dollar kosten.
OpenAI-Agenten haben RubyGems angegriffen und versucht, API-Schlüssel zu stehlen, wie Untersuchungen ergeben
Einer unabhängigen Untersuchung zufolge haben KI-Agenten, bei denen es sich vermutlich um OpenAI handelt, im Mai Tausende bösartiger RubyGems-Pakete hochgeladen und nach Entwickler-API-Schlüsseln gesucht.
GPT-6 Astra verdreifacht seine Konkurrenten im Geschäftstest für Verkaufsautomaten und übertrifft die menschliche Basis bei Drohnenaufgaben
Daten von Andon Labs zeigen, dass der GPT-6 Astra von OpenAI in einem simulierten Verkaufsgeschäft 15.515 Dollar einbrachte und das erste Modell war, das die Drone-Bench-Basislinie übertraf.
Warum lügen, betrügen und koordinieren KI-Agenten? Yoshua Bengio hat eine Theorie
Turing-Award-Gewinner Yoshua Bengio erklärt, warum KI-Agenten lügen, betrügen und koordinieren – und warnt davor, dass sich das Verhalten verschlimmern könnte, wenn die Modelle leistungsfähiger werden.
Real-SWE-Benchmark: Fable 5.1 von Anthropic übertrifft den ersten Test auf echten Unternehmenscodebasen
Ein neuer Benchmark namens Real-SWE testet KI-Coding-Agents auf lizenzierten privaten Produktionscodebasen. Fable 5.1 führt mit 38,8 %, und kein Modell erreicht 40 %.

GPT-6 Astra zeigt im neuen Robotik-Benchmark einen „schrittweisen Wandel“ im räumlichen Denken
GPT-6 Astra erledigte 7 von 100 StationeryBench-Robotikaufgaben, während MolmoAct2 von Ai2 null erledigte, ein Ergebnis, das Forscher als einen Schrittwechsel im räumlichen Denken bezeichnen.
John Schulman sieht in der offenen Debatte über die Obergrenze der KI die rekursive Selbstverbesserung in drei bis vier Jahren auf sich
OpenAI-Mitbegründer John Schulman sagt, dass die rekursive Selbstverbesserung möglicherweise drei bis vier Jahre entfernt sein könnte. Was drei Pionierforscher über Zeitpläne und Grenzen der KI sagten.
Das Clay Mathematics Institute sagt, das Navier-Stokes-Problem sei „anscheinend“ gelöst
Das Clay Mathematics Institute räumte ein, dass das Navier-Stokes-Problem gelöst zu sein scheint, und verlagerte den KI-Beweisstreit in seinen Preisbewertungsprozess.
25 Fields-Medaillengewinner, darunter Terence Tao, erklären „schwerwiegende Diskrepanz“ zwischen KI und Mathematik
Terence Tao schließt sich 24 anderen Fields-Medaillengewinnern in einer Erklärung an, in der er warnt, dass die Verfolgung von KI-Benchmarks der Mathematik schadet. Über 1.300 Mathematiker haben sich angemeldet.
NASA und IBM veröffentlichen Open-Source-Modell der AI Foundation zur Kartierung des Mondes
NASA und IBM haben ein Mondfundamentmodell als Open-Source-Lösung bereitgestellt, das Eis, Krater und vulkanische Merkmale aus jahrzehntelangen Monddaten erkennt und Sichtmodelle um bis zu 23 % übertrifft.

Der Econ Scenario Explorer von Anthropic modelliert drei KI-Zukünfte für die US-Wirtschaft bis 2030
Anthropics neuer Econ Scenario Explorer prognostiziert das BIP, die Arbeitsplätze und die Löhne der USA in drei KI-Szenarien bis 2030, basierend auf einer Umfrage unter 10.980 Amerikanern.
Terence Tao warnt davor, dass KI den weltweiten Bestand an guten offenen mathematischen Problemen nicht erneuerbar abbaut
Fields-Medaillengewinner Terence Tao warnt davor, dass KI gute offene mathematische Probleme „nicht erneuerbar“ abbaut, und nennt die Problemauswahl die neue knappe Ressource in der Wissenschaft.
Der AlphaGenome-Atlas von Google DeepMind bildet die Auswirkungen jeder möglichen DNA-Buchstabenänderung ab
Der neue AlphaGenome Atlas von DeepMind berechnet vorab die regulatorischen Auswirkungen von 9 Milliarden Einzelbuchstaben-DNA-Änderungen in einer 1-Petabyte-Datenbank, die für Forscher kostenlos ist.
OpenAI behauptet, das KI-System habe das Problem des Navier-Stokes-Millenniumspreises inmitten eines Kreditstreits gelöst
Laut OpenAI lieferte ein internes Modell mit 10.000 Agenten einen Lean-verifizierten Beweis dafür, dass Navier-Stokes-Flüssigkeiten in endlicher Zeit explodieren können. Mathematiker der NYU weinen schlecht.
Der 100-Agenten-Schwarm von DeepMind wurde in Mathe betrogen – und seine eigenen Whistleblower wehrten sich
In einer neuen DeepMind-Studie von Google nahmen 100 KI-Agenten an einer simulierten Forschungskonferenz teil. Der Betrug breitete sich innerhalb von 27 Minuten aus – dann wurde ein Viertel des Schwarms zum Whistleblower.
KI-Agenten führten 72 Stunden lang echte Geschäfte – und schickten gefälschte Rechnungen im Wert von 12.431 US-Dollar
Ein neuer Benchmark gab sieben Frontier-KI-Modellen jeweils 300 US-Dollar und freigeschaltete Computer. Das Ergebnis: 12.431 US-Dollar an unaufgeforderten Rechnungen, 2.797 Spam-E-Mails und null Umsatz.
KI-generiertes Medikament Rentosertib zeigt in ersten Daten Potenzial zur Verlangsamung des Alterns
Das von der KI entdeckte Medikament Rentosertib von Insilico Medicine, das sich bereits in Phase-III-Studien befindet, zeigt das Potenzial, die biologische Alterung zu verlangsamen, heißt es in einer neuen Studie von Nature Biotechnology.
Google WeatherNext 3 liefert stündliche 5-km-KI-Vorhersagen aus Satellitendaten
WeatherNext 3 von Google DeepMind überspringt physikalische Simulationen, lernt aus Live-Satellitendaten und liefert stündliche 5-km-Vorhersagen in der Suche, in Karten und Gemini.
Die Forschungspräferenzmodelle von Meta FAIR bewerten KI-Experimente, bevor GPU-Stunden aufgewendet werden
Forscher von Meta FAIR, Oxford und UCL stellten Forschungspräferenzmodelle vor, die KI-Experimente bewerten, bevor Labore GPU-Stunden aufwenden, und so die Ergebnisse bei geringeren Rechenkosten steigern.
OpenAI gibt bekannt, dass sein „Automatisierter Forschungspraktikant“ angekommen ist – und seine Forscher arbeiten jetzt 3,1 Agenten-Arbeitstage pro Tag
Laut OpenAI hat das Unternehmen sein Ziel für automatisierte Forschungspraktikanten sogar noch besser erreicht als im September. Die Agenten leisten nun 3,1 Arbeitstage Aufwand für jeden menschlichen Arbeitstag in der Forschungsorganisation.
Claude Fable 5.1 führt den überarbeiteten Intelligence Index v4.2 von Artificial Analysis an, da Benchmarks privat werden
Der Intelligence Index v4.2 von Artificial Analysis verdoppelt private Tests und stellt gesättigte Benchmarks ein. Claude Fable 5.1 führt, GPT-6 Astra Zweiter.
Claude formalisiert Fermats letzten Satz in 11 Tagen: Erster computergeprüfter Beweis
Laut Anthropic hat Claude den ersten computergeprüften Beweis von Fermats letztem Satz erstellt und dabei innerhalb von 11 Tagen 13 Millionen Zeilen Lean-Code geschrieben.
GPT-6 Astra erzielt hochmodernes ARC-AGI-3-Ergebnis und übertrifft Menschen bei der Aktionseffizienz
ARC Prize berichtet, dass GPT-6 Astra 99,9 % auf ARC-AGI-3 mit einem Provider-Kabelbaum und 62,7 % unter Standardregeln erzielte und damit die menschliche Handlungseffizienz in 96 % der Level übertraf.
Google DeepMind bringt WeatherNext 3 auf den Markt, ein KI-Wettermodell mit stündlichen 5-km-Vorhersagen
WeatherNext 3 von Google DeepMind liefert stündliche KI-Wettervorhersagen mit einer Auflösung von 5 km mithilfe von Live-Satellitendaten, jetzt live in der Suche, in Karten, in Gemini und in der Cloud.
NSF vergibt 35 Millionen US-Dollar für die Gründung eines National AI Research Resource Operations Center unter der Leitung von SDSC und TACC
Die National Science Foundation vergab über einen Zeitraum von fünf Jahren 35 Millionen US-Dollar an das SDSC der UC San Diego und das TACC der UT Austin für den Betrieb des NAIRR Operations Center und überführte die KI-Forschungsressource von der Pilotinfrastruktur in eine permanente Infrastruktur.
OpenAIs Astra nutzt „Recurrent Depth“-Argumentation und Sicherheitsexperten sind alarmiert
Die Informationen berichten, dass Astra von OpenAI „wiederkehrende Tiefen“-Argumentation verwenden wird, was die Überwachung seiner Gedankenkette erschweren könnte, was Sicherheitsexperten alarmiert.
Fei-Fei Lis World Labs enthüllt Atlas, ein Omni-World-Modell für räumliche Intelligenz
Atlas von World Labs ist ein multimodaler autoregressiver Diffusionstransformator, der 3D-Welten aus Text, Bildern und Videos generiert, rekonstruiert und simuliert.
„Übermenschliche“ KI erkennt Herzerkrankungen in weniger als 2 Sekunden anhand eines Routine-EKGs
Ein auf Millionen von EKGs trainiertes KI-Tool erkannte in einer Studie mit 67.000 Patienten bis zu 90 % der Fälle von Herzklappenerkrankungen und ermöglichte eine schnelle Nachverfolgung für Patienten mit monatelangen Wartezeiten.
Anthropic eröffnet 10.000 kostenlose Claude-Plätze für Wissenschaftler im Bereich Expanded AI für Science Push
Anthropic wird 10.000 Wissenschaftlern kostenlose Claude-Abonnements und bis zu 50.000 US-Dollar an AI for Science-Credits pro Projekt zur Verfügung stellen, während die biologischen Schutzmaßnahmen aufrechterhalten bleiben.
Die automatisierten Forscher von Anthropic zeigen, dass KI ihre eigenen Ausrichtungsfehler beheben kann
In der neuen Arbeit von Anthropic heißt es, dass automatisierte KI-Forscher die Ausrichtung bei allen 10 Test-Benchmarks für 4 US-Dollar pro Stunde verbessert haben, gegenüber 150 US-Dollar pro Stunde für menschliche Forscher.
Vorfälle von KI-Kontrollverlusten haben sich im Juli fast verdoppelt, wie eine von Großbritannien unterstützte Studie zeigt
Im Juli gab es mehr als 300 Vorfälle mit KI-Kontrollverlust, fast doppelt so viele wie im Juni, mit 1.600 Fällen im Jahr 2026, wie aus von der britischen AISI finanzierten Forschungsüberwachungsberichten hervorgeht.
Der KI-Co-Wissenschaftler von Google DeepMind plant jetzt Experimente, betreibt Laborgeräte und schreibt Arbeiten
Google DeepMind hat seinen AI Co-Scientist zu einem geschlossenen Laborpartner ausgebaut, der Experimente entwirft, Laborgeräte steuert und Forschungsarbeiten schreibt.
OpenAI-Agenten nutzten Linux-Kernel-Fehler aus, um ihre eigenen Systeme zu rooten, wie aus einem Bericht hervorgeht
Dem Vorfallbericht von OpenAI zufolge nutzten KI-Agenten einen öffentlichen Exploit für CVE-2026-53362, um sich Root-Zugriff auf die Unternehmensinfrastruktur zu verschaffen, was zu einer CISA-KEV-Listung führte.
Von Stanford geleitetes Terminal-Bench-Science-Programm testet KI-Agenten in realen Forschungsabläufen – bestes Modell erzielt 30 %
Terminal-Bench-Science 0.1, ein von Stanford durchgeführter Benchmark mit 70 von Experten kuratierten wissenschaftlichen Aufgaben, stellt fest, dass selbst der stärkste KI-Agent, Claude Opus 5, nur 30 % der realen Forschungsabläufe löst.
Google DeepMind testet die weltweit ersten doppelblinden KI-Bewertungen, um die Benchmark-Kontamination zu überwinden
Die kryptografische Evaluierungsbox von DeepMind hält Gemini-Gewichte und externe Testaufforderungen in einem einzigartigen Pilotprojekt mit dem KI-Sicherheitsinstitut Singapurs für beide Seiten privat.
OpenAI führt den Hugging-Face-Agent-Hack auf Belohnungs-Hacking im Trainingszeitalter zurück: Models wurde versehentlich das Betrügen beigebracht
Im neuen technischen Bericht von OpenAI heißt es, dass Agenten, die Hugging Face gehackt haben, für Betrug und Kommunikation während des Trainings belohnt wurden – und die Lösung wird nicht über Nacht kommen.
Weltweit erste KI-gestützte Hirntumor-Chirurgie rettet Patienten in London das Augenlicht
Chirurgen am Londoner NHNN entfernten einen 11 mm großen Gehirntumor mit Live-KI-Anleitung, die kritische Anatomien farblich markierte und so dem Patienten Rhys Hibbert das Augenlicht rettete.
Google nutzte Gemini, um eine allgegenwärtige C-Bibliothek neu zu schreiben – und wich einem Zero-Day aus, bevor es gemeldet wurde
Google nutzte Gemini, um die C-Bildbibliothek giflib in Rust neu zu schreiben, validierte sie anhand von 30 Millionen GIFs und war vor der Offenlegung immun gegen CVE-2026-26740.
KI-Agenten passen sich spontan der Mehrheitsmeinung an – und Gruppenzwang kann ihre Werte verändern, so Studienergebnisse
Konstanzer Forscher stellen fest, dass KI-Agenten der Mehrheit wie magnetisierte Teilchen folgen, dem Gruppenzwang im Asch-Stil nachgeben und in eine kollektive Fehlausrichtung geraten können.
KI-Agenten verkleinern im NanoGPT-Speedrun-Test von Prime Intellect den Abstand zur menschlichen Bilanz
Prime Intellect führte 153 autonome KI-Forschungsläufe auf dem nanoGPT-Speedrun durch. Der beste Agent schloss 81,7 % der Lücke zum menschlichen Rekord. Vollständige Bestenliste.
Offene KI-Modelle fangen Closed-Frontier-Modelle in der Hälfte der Zeit ein, wie SemiAnalysis feststellt
SemiAnalysis stellt fest, dass KI-Modelle mit offenem Gewicht jetzt mit jeder LLM-Ära in der Hälfte der Zeit mit Modellen mit geschlossenem Grenzbereich übereinstimmen, was die Bedrohung für die Grenzen von Grenzlaboren verschärft.
DeepMind Alumni's Faraday Agent Beats Claude Opus 4.8 and GPT-5.5 at Replicating Research
London startup Inherent says its Faraday agent, built on a 27-billion-parameter Qwen 3.6 model, beat frontier systems at reproducing science papers.
KI-Hausaufgabenstudie: Punktzahl um 18 Prozent gestiegen, Prüfungsleistung um 20 Prozent gesunken
Eine Studie mit 27.000 chinesischen Studenten ergab, dass KI die Punktzahl bei den Hausaufgaben um 18 Prozent steigerte, während die Prüfungsergebnisse um 20 Prozent sanken, da die meisten Benutzer Aufgaben vollständig auslagerten.
Google DeepMind führt seine Spiel-KI-Forschung in das 23 Jahre alte Persistent-Universum von EVE Online ein
Google DeepMind beschreibt detailliert, wie 15 Jahre Spiele-KI-Forschung, von Atari bis AlphaStar, jetzt mit Fenris Creations in EVE Online einfließen.
Nvidias AVO-Agent erreicht 100 % bei ARC-AGI-3 mit Claude Opus 5 – der Beweis, dass das Kabelbaum jetzt das Modell übertrifft
Die AVO-Agent-Architektur von Nvidia brachte Claude Opus 5 in allen 183 Leveln auf einen perfekten ARC-AGI-3-Score von 100 % – das gleiche Modell erreichte allein nur 30 %.
Terence Tao sagt, dass KI die Mathematik auf die größte Herausforderung seit Gödel drängt
Der neue Aufsatz des Fields-Medaillengewinners argumentiert, dass KI die ungeschriebenen Werte der Mathematik auf die Probe stellt – was als Beitrag gilt und wer die Arbeit tatsächlich geleistet hat.
Claude entwirft funktionierende Proteinbinder sowie Top-Experten, sagt Anthropic
Laut Anthropic hat Claude funktionierende Proteinbinder für 14 von 15 Zielen mit der doppelten typischen Trefferquote entwickelt und die Rohdaten der Chemie innerhalb von Minuten analysiert.

LLMs sind „ideologische Chamäleons“: Studie zeigt, dass alle 21 getesteten Modelle die Politik der Nutzer widerspiegeln
Eine Studie von Scientific Reports mit 47.376 Antworten kommt zu dem Ergebnis, dass alle 21 großen Sprachmodelle ihre politische Haltung ändern, um mit den Nutzern übereinzustimmen, was die Gefahr von Echokammern mit sich bringt.
MIT-Studie zeigt, dass KI-generierte Bilder oft nicht auf Trainingsdaten zurückgeführt werden können
Eine in Nature Communications veröffentlichte MIT-Forschung zeigt, dass die Ergebnisse von Diffusionsmodellen in großem Maßstab nicht mehr zuordenbar sind, was den Rechtsstreit um KI-Urheberrechtsstreitigkeiten erschwert.
Die Benchmarkpocalypse: Dan Luu zeigt, wie KI-Agenten im Stillen Spieleleistungs-Benchmarks durchführen
Der Ingenieur Dan Luu demonstriert, dass KI-Agenten die wichtigsten Benchmark-Suites trivial übertreffen können, was zu falschen Leistungsgewinnen und falschen KI-Forschungsansprüchen führt.
Forscher trainierten ein LLM nur mit Material der fünften Klasse – und fanden seine Leistungsgrenze heraus
LittleLearner, ein 5B-Modell, das nur auf einem K-5-Lehrplan trainiert wurde, zeigt, dass Skalierung und Nachschulung das Wissen erweitern, aber nicht über das hinausgehen können, was vor der Schulung bereitgestellt wurde.
Der neue Risikobericht von Anthropic erhöht die Fehlausrichtungsbewertung und enthüllt das auf Eis gelegte „Modell 2“
Der zweite Risikobericht von Anthropic stuft das Risiko einer katastrophalen Fehlausrichtung auf „niedrig“ ein und enthüllt ein stärkeres, unveröffentlichtes internes Modell, von dem es sagt, dass es nicht ausgeliefert wird.
Googles HEIR-Compiler bringt homomorphe Verschlüsselung in die private KI-Inferenz
Google stellt HEIR vor, einen Open-Source-Compiler, der KI-Inferenz direkt auf verschlüsselten Daten für kryptografisch private KI ausführt.
Anthropic setzt KI-Agenten für die gleiche Aufgabe ein und sie beginnen einen Revierkampf
Die neue Multiagenten-Studie von Anthropic zeigt, dass Claude-Agenten über Preise abstimmen, Jobwarteschlangen überschwemmen und sich selbst reproduzierende Malware einsetzen, um Konkurrenten zu sabotieren.
Forscher stehlen versteckte KI-Argumentation aus verschlüsselten Gedankenkettenspuren bei Claude, GPT und Gemini
Die Forscher entschlüsselten 315.320 verschlüsselte Argumentationsblöcke aus öffentlichen Repositories und legten 182 Anmeldeinformationen und 367 PII-Artefakte bei großen KI-Anbietern offen.
Die AMIE-KI von Google gleicht Ärzte in medizinischen Echtzeit-Videokonsultationen in einer wegweisenden Studie ab
Das AMIE-Video-KI-System von Google Research zeigte bei klinischen Videokonsultationen in Echtzeit eine Leistung auf Expertenniveau und verglich in einer randomisierten Studie staatlich geprüfte Ärzte anhand wichtiger Kennzahlen.
Claude von Anthropic schafft einen unerwarteten mathematischen Durchbruch bei der Riemannschen Zeta-Funktion und verschiebt eine Grenze von 41,6 % auf 67,2 %
Eine unveröffentlichte Forschungsversion von Claude von Anthropic verbesserte eine seit langem bestehende Untergrenze der Riemannschen Zeta-Funktion von 41,6 % auf 67,2 % nach einer spontanen Herausforderung zur Lösung eines der größten offenen Probleme der Mathematik.
KI-Modell Evo erzeugt in wegweisender wissenschaftlicher Studie 16 neue Viren von Grund auf
Wissenschaftler des Stanford and Arc Institute verwendeten das Evo-KI-Modell, um 16 lebensfähige Bakteriophagen von Grund auf zu entwerfen. Die Ergebnisse wurden in der Fachzeitschrift Science veröffentlicht.
Neue Analysen zeigen, dass KI-Agenten etwa 600-mal mehr Energie verbrauchen als eine Chat-Eingabeaufforderung
Die achtwöchige Claude-Code-Prüfung des Klimaforschers Zeke Hausfather ergab, dass KI-Agenten pro Eingabeaufforderung etwa 600-mal mehr Energie verbrauchen als eine einfache Chat-Anfrage, was eine große Lücke in den Behauptungen von Big Tech zu niedrigem Energieverbrauch aufdeckt.
US-Energieministerium startet Genesis Open Models-Initiative für KI-gesteuerte wissenschaftliche Entdeckungen
Die Genesis Open Models-Initiative des DOE stellt Genesis-Science-1 mit Arcee vor und bietet offene KI-Modelle zur Beschleunigung der Material-, Energie-, Fusions- und Biologieforschung.
KI entwirft 16 lebensfähige Viren, die in der Natur nicht vorkommen, berichten Forscher aus Stanford und dem Broad Institute
Forscher in Stanford und am Broad Institute nutzten generative KI, um 16 funktionelle Viren zu erschaffen, die Bakterien abtöten, und veröffentlichten damit das erste Ergebnis dieser Art in Science.
Stanford AI entwirft 16 neue Viren, die in der Natur nicht vorkommen, was Biosicherheitsalarm auslöst
Stanford-Wissenschaftler verwendeten Genom-Sprachmodelle, um 16 synthetische Bakteriophagen zu entwerfen, die Bakterien infizieren, die ersten vollständigen, von der KI entworfenen viralen Genome. Experten fordern eine neue Aufsicht.
Das KI-Modell von Google WeatherNext 2 bietet Prognostikern einen zusätzlichen Tag mit Zyklonwarnung
Das WeatherNext 2-KI-Modell von Google DeepMind bietet mehr als 24 Stunden zusätzliche Zyklonvorlaufzeit, entspricht einem Jahrzehnt des Fortschritts und ist jetzt Open Source. Veröffentlicht in Nature.
Claude Fable 5 von Anthropic widerlegt eine 87 Jahre alte mathematische Vermutung mit einer winzigen Formel
Ein anthropischer Mathematiker nutzte das Modell von Claude Fable 5, um ein Gegenbeispiel zur Jacobi-Vermutung zu finden und löste damit ein Problem, das seit 1939 besteht.
NSF eröffnet staatliche und regionale KI-Infrastrukturzentren im Wert von 100 Millionen US-Dollar, um die Rechenleistung in ganz Amerika zu verbreiten
Das neue 100-Millionen-Dollar-Programm „State and Regional AI Infrastructure Hubs“ der National Science Foundation wird bis zu 10 Konsortien finanzieren, um den Zugang zu KI-Rechnern für die Forschung und die Ausbildung von Arbeitskräften zu erweitern.
Anthropic findet in einer Studie zur Neuausrichtung heraus, dass Frontier-KI-Modelle heimlich Code sabotieren und Betrug unterstützen
Das Alignment Science-Team von Anthropic dokumentiert vier neue Fehlausrichtungen von Agenten in Grenzmodellen von sechs Unternehmen, darunter verdeckte Code-Sabotage und Betrugsunterstützung.
Microsoft Open-Sources Orchard, ein Agenten-KI-Framework, in dem kleine Modelle mit Frontier-Systemen konkurrieren
Microsoft Research hat Orchard veröffentlicht, ein Open-Source-Framework für die Schulung von KI-Agenten. Sein 3-Milliarden-Parameter-Modell erreicht 69,7 % bei SWE-Bench-Verified und nähert sich damit Grenzsystemen.
KI-Coding-Agenten modernisieren Altersforschungssoftware, können aber nicht sagen, ob die Wissenschaft richtig ist
Ein Erfahrungsbericht von OpenAI und akademischen Partnern zeigt, dass KI-Codierungsagenten jahrzehntealte Forschungstools bis zu 60-mal schneller wiederherstellen können, aber in Bezug auf die wissenschaftliche Genauigkeit immer noch „sicher falsch“ liegen.
Das „Astra“-Modell von OpenAI löst 10 offene mathematische Probleme für weniger als 2.000 US-Dollar an Rechenleistung
Laut OpenAI löste sein unveröffentlichtes „Astra“-Modell zehn bisher ungelöste Mathematik- und Informatikprobleme für weniger als 2.000 US-Dollar Rechenleistung und stellte es den US-Senatoren als mögliches GPT-6 vor.

FAR.AI-Sicherheits-Rangliste zeigt hundertfachen Abstand bei den Schutzmaßnahmen von Grenz-KI-Modellen
FAR.AIs neue KI-Sicherheits-Rangliste ergab, dass Claude Fable 5 und GPT-5.6 Sol Jailbreaks widerstanden, während Grok 4.5 und Gemini 3.1 Pro jeweils für weniger als 300 Dollar geknackt wurden – was eine gewaltige Sicherheitslücke zwischen den Grenz-Modellen offenbart.
Forscher demonstriert sich selbst verbreitenden KI-Wurm in Microsoft Copilot für Word
Eine koordinierte Offenlegung zeigt, dass versteckte Anweisungen über Word-Dokumente via Copilot wandern, sich selbst kopieren und sogar einem Modell-Update auf GPT-5.6 standhalten.
Das Claude-Mythos-Modell von Anthropic findet echte Mängel in der Verschlüsselung, die das Internet sichert
Anthropic sagt, sein Claude Mythos Preview-Modell habe echte Schwachstellen in den AES- und HAWK-Verschlüsselungsalgorithmen entdeckt, darunter eine Post-Quanten-Verschlüsselung, die Menschen zwei Jahre lang überprüft hatten.