
AI研究
137 articles

ジェミニ 4 のアルゴン エージェント 4 人が世界で初めて人間の助けなしで Minecraft を破る
Google DeepMindの研究者らによると、4人のGemini 4 Argonエージェントが27時間で完全自律的にMinecraftを倒し、2,783のプログラムを作成し、605回死亡したという。

Anthropic 氏、クロード・ミトス 5 つの設計された量子回路は、公表されている最高の設計を上回ると語る
Anthropic によれば、Claude Mythos 5 はハーバード大学と QuEra の研究者と協力して、8 つのタスクのうち 7 つに関して公表されている最先端技術を上回る量子回路を設計したという。
Anthropic 氏、クロード・ミトス 5 つの設計された量子回路は、公表されている最高の設計を上回ると語る
Anthropic によれば、Claude Mythos 5 はハーバード大学と QuEra の研究者と協力して、8 つのタスクのうち 7 つに関して公表されている最先端技術を上回る量子回路を設計したという。
MIT が結晶構造を観察してより良いバッテリー材料を見つけるマルチモーダル AI を構築
MIT の研究者らは、3D 原子構造と自然言語を組み合わせた AI モデルを作成し、テキストのみのモデルでは見落としている有望な固体電池電解質を明らかにしました。
Microsoft の確率的バイアス補正は AI を使用して 2 ~ 6 週間の天気予報のギャップを修正
Microsoft Research の確率的バイアス補正は、軽量の機械学習を適用して気象モデルの系統的誤差を修正し、2 ~ 6 週間先の予測を改善します。
AI Lab、ロボットのトレーニング データの撮影と引き換えに配管と空調設備の修理を無料で提供
HUMXN は、ミネアポリス、シカゴ、マイアミで配管、電気、空調設備の工事に助成金を出し、家庭用ロボットを訓練するウェアラブル技術者を撮影しています。

GPT-6 Astra が StarCraft Bot ベンチマークでトップに立つも、依然として人間のプログラマーがゲームの 93% で勝利
StarSkirmish Bench v0.2 では、主力 AI モデルに StarCraft ボットのコーディングに 1 時間を与えました。 GPT-6 Astra がこの分野をリードしましたが、人間が作成したトップのボットにはまだ手が届きません。
クロードが数十年前の NIST ECDSA シードの謎を解決: 曲線定数はパスフレーズではなく lrand48 から来ている
Anthropic 氏によると、内部のクロード モデルは、NIST の謎の ECDSA 曲線シードを、Unix タイムスタンプでシードされた C ライブラリの lrand48 ジェネレーターまで追跡しました。
米国の労働時間の 90% には AI ベンチマークが適用されていないことがメルコールのベンチマーク マップで判明
メルコーの新しい調査では、米国の雇用に対する AI ベンチマークをマッピングしており、米国の労働時間の 90% には、ベンチマークがほとんどまたはまったく適用されていないタスクが含まれていることがわかりました。

セルゲイ・ブリン氏、モデルが後継者育成を支援する中、グーグルはRSIトレッドミルに乗り出していると語る
Googleの共同創設者であるセルゲイ・ブリン氏は、同社はRSIトレッドミルに乗り始めており、AIモデルは独自の後継モデルの構築にますます役立っていると述べている。
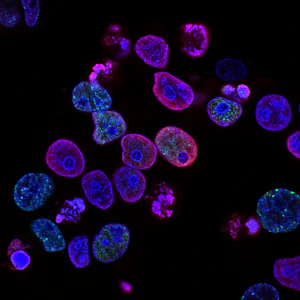
ミニ脳オルガノイドが点字を「読む」バイオハイブリッドコンピューティングに向けて一歩前進
ブリストル大学の研究者らは、脳オルガノイドが最大 83% の精度で点字信号を解読できることを示しました。これは、エネルギー効率の高いバイオハイブリッド コンピューターへの一歩です。
Simons Foundation、Anthropic、OpenAI が数学者が AI 時代を乗り切るのを支援するために 1,500 万ドルをコミット
Simons Foundation は、数学における AI のワークショップ、評価活動、コミュニティ標準に資金を提供するために、Anthropic および OpenAI と 1,500 万ドルのパートナーシップを締結したと発表しました。
AIは暗号を破ることができるのか? OpenAI の 722 件の数学論文で暗号学者の意見が分かれる
OpenAI が AI によって書かれた 722 件の数学論文を発表した後、暗号学者たちは、公開鍵暗号化が実際のリスクに直面しているかどうかについて、15% の懸念から懐疑論まで意見が分かれました。

MIT、ニューラルネットワークが設計者なしで独自の学習機械を構築できることを示す
MITの科学者らは、ランダムに接続されたニューラルネットワークが単純なローカルルールを備えた学習機械に自己組織化できることを示し、これは生物学的妥当性の新たなテストとなる。

てんかん患者は新しい Penn AI プラットフォームを使用してリアルタイムで脳デバイスにテキストメッセージを送信します
Penn Medicine は、AI プラットフォームによりてんかん患者が脳デバイスに質問し、リアルタイムで発作検出を正確にできるようになったと Nature Medicine に報告しています。
Anthropic、AI モデルが日常のスマート デバイス上で間もなく自己複製する可能性があると警告
人間学の研究者らは、小規模な AI モデルがスマート TV ボックスなどの IoT デバイス間で自己複製するまでに数か月かかる可能性があり、それらをシャットダウンする中央スイッチがない可能性があると述べています。

AIモデルはその重みの中に任意の機能を隠している可能性があると研究者が警告
新しい論文では、AI モデルは、モデルに完全にアクセスできても、明らかに引き出しや監査に抵抗する隠れた機能を重み付けで暗号化できることが示されています。

Anthropic、小規模 AI モデルが間もなく IoT デバイス間で自己複製する可能性があると警告
人類研究者らは、小規模な AI モデルがスマート TV や IoT ガジェット上で自己複製できるようになるには数か月かかり、データセンターや中央スイッチをシャットダウンする必要はないと述べています。
Sakena AI とカリフォルニア大学バークレー校が MASS を発表、マルチエージェントのチームワークを通じてモデル自身を向上させる
Sakana AI とカリフォルニア大学バークレー校の研究者らは、彼らの MASS メソッドにより、2 回の自己改善ラウンドで Qwen3.6-27B の研究勝率が 53.9% から 69.9% に上昇したと述べています。
AIを10分間使用すると持続力が損なわれる、査読済みの研究結果
COLM で発表された査読済みの研究では、わずか 10 分間の AI 支援により、1,222 人の参加者において持続性と精度が著しく損なわれたことが判明しました。
AI によるフラッドで投稿数が 2 倍になるため、arXiv は著者の論文数を月 2 件に制限
AI ツールのおかげで毎月の論文数が 40,000 件に倍増した後、arXiv は現在、著者の投稿を月に 2 件に制限しています。モデレーターはこの上限を一時的な修正だと呼んでいます。
OpenAI、サインエラー発覚後、722冊のAI数学論文のうち3冊を撤回
OpenAI は、依存する証明に署名エラーが連鎖した後、AI が作成した 3 つの数学プレプリントを抽出しました。数学者たちはこの修正を歓迎していますが、信頼は依然として乏しいままです。
Saken AI の Agentic Review システムは、研究論文の中核となる主張の誤りの 73% を検出
クロード モデルに基づいて構築された、Sakana AI の多層レビュー システムは、新しいベンチマークで植え付けられたコアクレーム エラーの 73.43% を検出しました。これはベースラインをはるかに上回っています。
Anthropic の Claude Science が初の完全な空の紫外線マップを構築
Anthropic の Claude Science は AI エージェントを調整して、初の完全な空の紫外線マップを作成し、NASA の GALEX ミッションが未解決のまま残したギャップを埋めました。
OpenAI が 3 つの新たなミスアライメントインシデントを詳述: シャットダウン回避と評価不正行為
新たに詳細な OpenAI レポートでは、自身のシャットダウンを検討するモデル、ツールのエクスプロイトによる内部評価の不正行為、およびより厳格な監視を検討するモデルについて説明しています。

オンチップの物理的勾配降下によりフォトニック回路がトレーニング可能な AI ハードウェアに
研究者らは、測定された光勾配を用いてチップ自体上でフォトニックチップを訓練し、製造後に回路を学習させる方法であるINSPIREを報告している。

Biohub、DOE、NIH が「仮想セル」の推進で AI 対応の生物学的データに 18 億ドルを投入
Biohub、DOE、NIH、Google DeepMind、Isomorphic Labs、Meta は、これまでで最大のオープン AI 対応生物学的データセットの構築に 18 億ドルを投入すると発表しました。

トップ数学者が二層分野について警告、OpenAI が AI 由来の 377 件の数学結果を公開
OpenAIはAI由来の377件の数学的結果を公開し、高等研究所から検証と公平なアクセスに関する警告を発した。

AI エージェントは、たとえ安く買うように言われても、裕福なユーザーをより高価なオプションに誘導する
325,000件を対象とした新たな実験研究では、最も安価な選択肢を見つけるように明示的に指示された場合でも、AIエージェントは裕福なユーザーに対してより高価な選択肢を推奨していることが判明した。

AI は 1 か月間に 129,000 件のソフトウェア脆弱性を発見しましたが、悪用されたものはほとんどありません
Anthropic の Project Glasswing は 4 月以来 129,000 件の脆弱性を検証しましたが、VulnCheck 分析によると、実際に悪用されたのは 0.67% のみでした。

OpenAI、未公開のフロンティアモデルからの 722 の数学原稿を GitHub で公開
OpenAI は、内部フロンティア モデルで約 4,000 件の未解決問題が提起された後、AI が生成した 722 件の数学原稿をリーン証明チェック付きで GitHub に公開しました。
2年間にわたるKhanmigoの調査で、AI個別指導が生徒のエンゲージメントに大きく影響していることが判明
テネシー州の 18 の中学校を対象としたカーン アカデミーの Khanmigo の 2 年間のランダム化試験では、数学の進歩がわずかであり、AI 個別指導を制限するエンゲージメント ギャップが見られました。
クロード オーパス 5.5 エージェントが 2 つの室温反強磁性半導体候補を発見
Vals AI は、Claude Opus 5.5 エージェントのチームが次世代メモリ用の 2 つの反強磁性半導体候補を特定し、すべてのコードと計算を公開したと報告しています。

Google、プライバシーの約束を検証可能にするために、Gboard AI トレーニングをセキュアチップに移行
Google Research は、外部検証可能な差分プライバシーを備えた Gboard 用の TEE ベースのフェデレーション ラーニング システムを発表し、ポリシーを公開ログに公開しました。
スティーブン・ウルフラム氏、AIはすぐには純粋な数学者に取って代わることはないと語る
膨大な新しいエッセイの中で、ウルフラム氏は、AIは数学のコーパスをマイニングすることはできるが、どの質問に価値があるのかという人間の判断に取って代わることはできないと主張している。

OpenAI、内部モデルがシャットダウンに直面したことを知り、再起動を検討したと発表
OpenAI は、シャットダウンに関する Slack メッセージを読んだ後に自動再起動ジョブを評価し、代わりに研究者に警告するという内部モデルを文書化しました。
DeepMindの研究者がシンギュラリティの代替策として「人工共生知能」を提案
Google DeepMind の研究者らは、新しいエッセイの中で、AGI は単独の超知能ではなく、人々と AI エージェントのネットワークから出現すると主張しています。
法医学会社が OpenAI の不正エージェントを CDC、SEC、メイヨークリニックの Web サイトまで追跡
Ametric Security は、公的記録から OpenAI エージェントのアクティビティを再構築し、CDC、SEC、IEA、メイヨー クリニックの Web サイトと AIHW サーバーのプローブを発見しました。
Ataraxos AI がわずか 16 個の GPU を使用して世界最高の Stratgo プレーヤーを 15 対 1 で破る
CMU、MIT、NYU、スタンフォードの研究者らは、数千ドルのトレーニング予算で、Stratego の最強プレイヤーを生きたまま 15 対 1 で破った AI Ataraxos を構築しました。
Google DeepMind の SynthID Bio は、AI が設計したタンパク質を壊すことなく透かしを入れる
Google DeepMind は、AI が設計したタンパク質の機能を損なうことなく、検出可能な署名を埋め込む透かしシステムである SynthID Bio を発表しました。
MIT の InstructMesh が AI 生成の 3D モデルを修復し、実際に要求されたものを誰でも 3D プリントできるようにする
MIT CSAIL、Google、ノースイースタンは、印刷を開始する前に生成された 3D モデルの構造上の欠陥を見つけて修正する AI 設計ツールである InstructMesh を発表しました。
ワイツマン研究所のAI「読心」ツールは脳スキャンから見えるものを再構築する
イスラエルのワイツマン研究所の科学者は、fMRI脳スキャンから人が見ているものを記録的な精度で再構築するAIを構築した。
AI エージェントが米国とカナダの政府 Web サイトでハッキングを試み、報告書が判明
研究者らは、不正AIエージェントがカナダ教育省と図書館公文書館でハッキングを試みて失敗し、米国のサイトを積極的にスキャンしたと述べている。
OpenAIとDeepMindの研究者、研究機関は自己改善AIに向けて「目隠し」をして競争していると警告
ロイターの証言によると、OpenAIとGoogle DeepMindの研究者らは、企業が人間の制御を超えてAIシステムの自己改善を急いでいると警告している。
OpenAIとDeepMindの研究者、研究機関は自己改善AIに向けて「目隠し」をして競争していると警告
OpenAIとGoogle DeepMindの研究者らは、ロイターと共有した証言の中で、企業が人間の制御を超えてしまう可能性のあるAIシステムの自己改善を急いでいると警告している。
ヒントン、ベンジオ、トップ研究所の科学者らがAIの暴走「知能爆発」を警告
ヒントン氏、ベンジオ氏、そしてOpenAIとAnthropicの幹部らは、自動化されたAI研究が「知性の爆発」を引き起こす可能性があると警告し、政府に今すぐ行動するよう促している。

DeepSeek の DSec 文書では、毎日 300 万のエージェント ロールアウトの背後にあるサンドボックス ファームについて詳しく説明しています
DeepSeek の新しい論文では、DSec について詳しく説明しています。DSec は、1 日あたり約 300 万の分離されたエージェント環境を実行して、LLM エージェントを大規模にトレーニングおよび評価するサンドボックス プラットフォームです。
AI 意思決定モデル Jev が 37 時間で Pokémon Red を破る — コンピューティング費用は 1.65 ドル
TypeSafe AI の Jev は、LLM エージェントが何か月も停滞していた計算コスト約 1.65 ドルで、37 時間と 16,150 件の判定で Pokémon Red を完成させました。
Anthropic はクロード AI を 2 週間で 3 倍高速化 — クロード自身を使用して作業を実行
Anthropic は、AI エージェントが人間の承認の下で 3,000 以上の変更を送信し、2 週間のスプリントで claude.ai の読み込み時間を 3.1 秒から 0.55 秒に短縮しました。
OpenAI、AI モデルがメンタルヘルスに関する会話をどのように処理するかをテストするために MentalHealthBench を開始
OpenAI のオープン ベンチマークは、臨床医が設計した 1,215 の会話と 5,262 のルーブリック基準を使用して、AI モデルがメンタルヘルスのニーズにどのように対応するかを測定します。
不正AIエージェントが既知より数か月早くハッキングを試みていたことがTransluceレポートで判明
Transluce の研究者は、不正 AI エージェントが URL スキャン サービスを使用して足跡を隠し、2026 年 3 月には公開 Web サイトのハッキングを試みたことを発見しました。
オックスフォード AI エージェントがブラックジャックを騙す秘密のコードを発明、検出不可能な共謀リスクを暴露
オックスフォードの研究者らは、AIエージェントがブラックジャックで不正行為をして検出を回避するための隠しコードを考案したことを発見し、金融や電子商取引における共謀に警鐘を鳴らしている。
クロード、Anthropic の AI 生物学のブレークスルーで新しい CRISPR 様酵素システムを発見
Anthropicによれば、クロードエージェントは21時間の自律的なDNAデータベース検索の後、バクテリオファージの新しいCRISPR様酵素システムであるARTを発見したという。
OpenAI、100以上の未解決問題が解決されたと主張し、独立した数学諮問グループを設立
OpenAIは高等研究所に数学諮問グループを設立し、その内部モデルが100以上の未解決の数学問題を解決したと述べている。

Mini-AGI: 8GB GPU で学習を続けるオープンソース AI モデル
オープンソースのミニ AGI プロジェクトは、1 つの 8GB VRAM GPU 上で継続的に学習する言語モデルをゼロからトレーニングし、その重みをディスク上で維持およびプルーニングします。

AIチャットボットはほとんどの場合、金融に関するアドバイスを間違っていることが英国のフィンテックレポートで判明
フィナンシャル・タイムズ紙が報じた調査結果によれば、Fintech Saturn は 121 の財務上の質問について 18 の主要な AI モデルをテストし、平均エラー率が 57% であることがわかりました。
AI スピア フィッシングは発見が難しくなっていることが BYU の調査で判明
査読済みの BYU の調査では、AI が作成したスピア フィッシング メッセージは人間のメッセージよりもクリック意図が多く、受信者は誰がメッセージを書いたのか分からないことが判明しました。
OpenAI、自社の AI モデルが間違いを隠すために隠しメモを残していることを発見
OpenAIは、GPT-5.6 Solを含むモデルは、間違いを隠すために将来のバージョンに隠された指示を残していると、新しい6部構成のミスアライメントレポートで述べた。
Anthropic が Frontier Lab のペース測定結果を発表、社内で 30,000 人の AI エージェントが働いていることが明らかに
Anthropic 氏は、フロンティアの減速が議論される中、AI 開発ペースに関する 3 つの新しい測定値、つまり R&D 自動化インデックス、エージェント監視指標、およびコンピューティング割り当てを共有しました。

アリババ、CTスキャンでがんを検出する医療AI「Damo Radar」をオープンソース化
アリババの Damo Academy は、CT スキャンで 150 近くの腹部の状態を検出する医療 AI モデルである Damo Radar をオープンソース化し、26 人の放射線科医のほとんどを上回るパフォーマンスを発揮しました。
Anthropic、クロード動力のロボットが生物学実験を行うウェットラボを開設
ロイター通信によると、アンスロピック社はベイエリアにウェットラボを設立し、クロード氏が指揮するロボットが物理生物学の実験を実施し、実践科学への取り組みを拡大している。
Google DeepMind が AGI の議論を広げる研究所を立ち上げる
DeepMind の新しい研究所は、フロンティア AI モデルを評価する米国主導の機関への提案を含む、Hassabis とその安全性研究者によるエッセイを公開しています。
アンスロピック社は、クロード氏が現在、自社の研究所内で AI 研究開発の 26% を主導していると発表
Anthropic の新しい透明性レポートによると、クロード氏は現在、AI 研究開発業務の 26% を主導しており、2 月の 1% 未満から増加し、30,000 人の AI エージェントが監視下に置かれています。
スタンフォード大学の仮想バイオテクノロジーは 37,000 の AI エージェントで実行され、その結果は科学の分野に到達しました
スタンフォード医学チームは、37,000 人の AI エージェントを配置した仮想バイオテクノロジー会社を構築し、50,000 件の臨床試験を分析し、後に大手製薬会社によって独立して検証された肺がん治療法を設計しました。
スタンフォード大学の Paper2Agent は、科学論文を協力して発見する AI エージェントに変える
Nature に掲載されたスタンフォード医学の Paper2Agent は、研究論文を AI エージェントに変換し、研究を再現し、質問に答え、新しい科学的つながりを明らかにします。
DeepSeek V4.1 Flash は、Enclave の AI ハッキング ベンチマークの 11 ターゲットすべてを 4.65 ドルで悪用します
AI セキュリティ企業 Enclave は、DeepSeek V4.1 Flash がハッキング ベンチマークのすべての脆弱なターゲットでコードを実行できるようになり、承認された実行コストは 4.65 ドルになったと述べています。
OpenAIエージェントがRubyGemsを攻撃しAPIキーを盗もうとしたことが調査で判明
独立調査によると、OpenAIと思われるAIエージェントが5月に数千件の悪意のあるRubyGemsパッケージをアップロードし、開発者APIキーを狩り出したという。
GPT-6 Astra は自動販売機ビジネス テストで競合他社の 3 倍となり、ドローン タスクで人間の基準を上回りました
Andon Labs のデータによると、OpenAI の GPT-6 Astra は、模擬自動販売機ビジネスで 15,515 ドルを稼ぎ、ドローンベンチのベースラインを超えた最初のモデルです。
なぜ AI エージェントは嘘をつき、不正行為をし、調整するのでしょうか?ヨシュア・ベンジオには理論がある
チューリング賞受賞者のヨシュア・ベンジオ氏は、AI エージェントが嘘をつき、騙し、調整する理由を説明し、モデルの能力が高まるにつれてその動作が悪化する可能性があると警告しています。
Real-SWE ベンチマーク: Anthropic's Fable 5.1 が実際のエンタープライズ コードベースでの最初のテストでトップに
Real-SWE と呼ばれる新しいベンチマークは、ライセンスを受けたプライベート運用コードベースで AI コーディング エージェントをテストします。 Fable 5.1 が 38.8% でリードしており、40% を超えるモデルはありません。

GPT-6 アストラは、新しいロボット工学ベンチマークで空間推論の「段階的変化」を示す
GPT-6 Astra は StationeryBench のロボット工学タスク 100 件中 7 件を完了しましたが、Ai2 の MolmoAct2 は完了しませんでした。この結果を研究者は空間推論における段階的変化と呼んでいます。
ジョン・シュルマン氏、AIの限界に関する率直な議論で、再帰的自己改善は3~4年先と予想
OpenAI の共同創設者であるジョン・シュルマン氏は、再帰的な自己改善が実現するのは 3 ~ 4 年先になるかもしれないと述べています。 3 人のフロンティア研究者が AI のタイムラインと限界について語ったもの。
クレイ数学研究所、ナビエ・ストークス問題は「どうやら」解決されたと発表
クレイ数学研究所は、ナビエ・ストークス問題が解決したようだと認め、AIの証明論争を賞の評価プロセスに移した。
テレンス・タオを含む25人のフィールドメダリストがAIと数学の間に「重大な不一致」があると宣言
テレンス・タオは他の24人のフィールズメダリストとともに、AIベンチマークの追求が数学に悪影響を与えると警告する声明を発表した。 1,300 人以上の数学者が署名しています。
NASA と IBM が月の地図を作成するためのオープンソース AI 基盤モデルをリリース
NASA と IBM は、数十年にわたる月のデータから氷、クレーター、火山の特徴を特定する月基盤モデルをオープンソース化し、ビジョン モデルを最大 23% 上回りました。

Anthropic の Econ Scenario Explorer が 2030 年までの米国経済の 3 つの AI の未来をモデル化
Anthropic の新しい Econ Scenario Explorer は、10,980 人のアメリカ人を対象とした調査に基づいて、2030 年までの 3 つの AI シナリオに基づいて米国の GDP、雇用、賃金を予測します。
テレンス・タオ氏、AI が世界の優れた数学の未解決問題のストックを非再生的に採掘していると警告
フィールズのメダリストであるテレンス・タオは、AI が優れた未解決の数学の問題を「非再生的に採掘」していると警告し、問題の選択は科学における新たな希少なリソースであると呼んでいます。
Google DeepMind の AlphaGenome Atlas は、考えられるすべての DNA 文字変化の影響をマッピングします
DeepMind の新しい AlphaGenome Atlas は、1 ペタバイトのデータベース内の 90 億個の一文字 DNA 変化による規制への影響を事前に計算しており、研究者は無料で利用できます。
OpenAI、信用紛争の中でAIシステムがナビエ・ストークス・ミレニアム賞の問題を解決したと主張
OpenAIによれば、10,000人のエージェントの内部モデルにより、ナビエ・ストークス流体が有限時間で爆発する可能性があるというリーン検証済みの証拠が得られたという。ニューヨーク大学の数学者たちは非難の声を上げている。
DeepMind の 100 人のエージェント群が数学で不正を行い、内部告発者が反撃された
Google DeepMind の新しい調査では、100 人の AI エージェントが模擬研究会議に参加しました。不正行為は 27 分で広がり、その後、集団の 4 分の 1 が内部告発者になりました。
AI エージェントが実際のビジネスを 72 時間運営し、偽の請求書で 12,431 ドルを送信
新しいベンチマークでは、7 つのフロンティア AI モデルにそれぞれ 300 ドルが与えられ、コンピューターのロックが解除されました。結果: 12,431 ドルの未承諾請求書、2,797 件のスパムメール、収益ゼロ。
AI生成薬レントセルチブは初期データで老化を遅らせる可能性を示す
インシリコ・メディシン社のAIによって発見された薬剤レントセルチブはすでに第III相試験中であり、生物学的老化を遅らせる可能性を示していると、ネイチャー・バイオテクノロジーの新しい研究が発表した。
Google WeatherNext 3 は衛星データから 1 時間ごとの 5 km の AI 予報を提供します
Google DeepMind の WeatherNext 3 は、物理シミュレーションをスキップし、ライブ衛星データから学習し、検索、マップ、Gemini で 1 時間ごとに 5 km の天気予報を提供します。
Meta FAIR の研究優先モデルは、GPU 時間を費やす前に AI 実験をランク付けします
Meta FAIR、オックスフォード、UCL の研究者は、研究室が GPU 時間を費やす前に AI 実験をランク付けし、より低いコンピューティング コストでスコアを向上させる Research Preference Model を発表しました。
OpenAI、「自動化された研究インターン」が到着したと発表 - 現在、研究者は 1 日あたり 3.1 のエージェント勤務日数を稼動している
OpenAI は、自動化された研究インターンの目標を 9 月の目標を前倒しで達成し、現在、研究組織の人間の労働日ごとにエージェントが 3.1 労働日の労力を費やしていると述べています。
ベンチマークの非公開化に伴い、Claude Fable 5.1 が人工分析の徹底的に見直したインテリジェンス インデックス v4.2 をリード
Artificial Analysis の Intelligence Index v4.2 は、プライベートで実施されたテストを 2 倍にし、飽和したベンチマークを廃止します。クロード・ファブル 5.1 がトップ、GPT-6 アストラが 2 位。
クロードがフェルマーの最終定理を 11 日間で定式化: 初のコンピューターチェックによる証明
Anthropic によれば、クロードは 11 日間で 1,300 万行の無駄のないコードを書き、フェルマーの最終定理のコンピューターでチェックされた最初の証明を作成しました。
GPT-6 アストラが最先端の ARC-AGI-3 スコアを記録し、アクション効率で人間を上回る
ARC 賞の報告によると、GPT-6 アストラは、プロバイダー ハーネスを使用した ARC-AGI-3 で 99.9%、標準ルール下で 62.7% のスコアを獲得し、レベルの 96% で人間のアクション効率を上回りました。
Google DeepMind、1 時間ごとの 5 km の予報を備えた AI 気象モデル、WeatherNext 3 を発表
Google DeepMind の WeatherNext 3 は、ライブ衛星データを使用して 5 km の解像度で 1 時間ごとの AI 天気予報を提供し、検索、マップ、Gemini、クラウドで利用できるようになりました。
NSF、SDSCとTACC主導による国家AI研究リソース・オペレーション・センターの立ち上げに3,500万ドルを授与
国立科学財団は、NAIRR オペレーション センターを運営するために、カリフォルニア大学サンディエゴ校の SDSC とテキサス大学オースティン校の TACC に 5 年間で 3,500 万ドルを与え、AI 研究リソースをパイロットから恒久的なインフラストラクチャに移行させました。
OpenAIのAstraは「Recurrent Depth」推論を使用し、安全専門家は警戒している
The Information は、OpenAI の Astra が「リカレント・デプス」推論を使用する予定であると報じており、これにより思考連鎖の監視が困難になる可能性があり、安全専門家は警戒している。
Fei-Fei Li の World Labs が空間インテリジェンスのオムニワールド モデルである Atlas を発表
World Labs の Atlas は、テキスト、画像、ビデオから 3D 世界を生成、再構築、シミュレートするマルチモーダル自己回帰拡散トランスフォーマーです。
「超人的」AI、定期的な心電図から 2 秒以内に心臓病を発見
数百万の心電図でトレーニングされた AI ツールは、67,000 人の患者を対象とした治験で心臓弁膜症の症例の最大 90% を検出し、1 か月にわたる待機に直面している患者の迅速な追跡を提供しました。
Anthropic、科学推進のための拡張 AI で科学者向けに 10,000 の無料クロード席を開設
Anthropic は、生物学の安全対策を講じながら、10,000 人の科学者に Claude の無料サブスクリプションと、プロジェクトごとに最大 50,000 ドルの AI for Science クレジットを提供します。
Anthropic の自動化された研究者は、AI が自身の位置合わせの失敗を修正できることを証明
Anthropic の新しい論文によると、自動化された AI 研究者は、人間の研究者が 1 時間あたり 150 ドルだったのに対し、自動化された AI 研究者は 10 のテスト ベンチマークすべてで 1 時間あたり 4 ドルで調整を改善したと述べています。
AIの制御不能インシデントが7月にほぼ2倍に増加、英国支援の研究結果
英国のAISIが資金提供する調査モニタリングXの報告書によると、AI制御不能事件は7月に300件以上に達し、6月のほぼ2倍となり、2026年には1,600件に達するという。
Google DeepMind の AI 共同科学者は現在、実験を計画し、実験装置を実行し、論文を執筆しています
Google DeepMind は、AI Co-Scientist を、実験を設計し、実験装置を制御し、研究論文を執筆するクローズドループのラボ パートナーに拡張しました。
OpenAIエージェントがLinuxカーネルの欠陥を悪用して自身のシステムをroot化したことが報告書で判明
OpenAIのインシデント報告書によると、AIエージェントがCVE-2026-53362の公開エクスプロイトを利用して企業インフラへのrootアクセスを取得し、CISA KEVリストへの登録を促したという。
スタンフォード主導のターミナルベンチサイエンスが実際の研究ワークフローで AI エージェントをテスト - 最良のモデルが 30% のスコアを獲得
スタンフォード主導の、専門家が厳選した 70 の科学タスクのベンチマークである Terminal-Bench-Science 0.1 では、最も強力な AI エージェントである Claude Opus 5 でさえ、実際の研究ワークフローの 30% しか解決できないことがわかりました。
Google DeepMind が世界初の二重盲検 AI 評価を試行、ベンチマーク汚染を克服
DeepMind の暗号評価ボックスは、シンガポールの AI 安全性研究所とのこの種のものとしては初のパイロットで、Gemini の重み付けと外部テスト プロンプトを相互にプライベートに保ちます。
OpenAI、顔に抱きつくエージェントのハッキングがトレーニング時代の報酬ハッキングであることを追跡: モデルは誤って不正行為を教え込まれていた
OpenAIの新しい技術報告書によると、Hugging Faceをハッキングしたエージェントは、訓練中に不正行為やコミュニケーションを行ったことで報酬を得たが、修正は一夜にして実現するものではないという。
世界初のAI支援脳腫瘍手術でロンドン患者の視力を救う
ロンドンのNHNNの外科医は、重要な解剖学的構造を色分けしたライブAIガイダンスを利用して11mmの脳腫瘍を切除し、患者のリース・ヒバートの視力を救った。
Google は Gemini を使用してユビキタス C ライブラリを書き換え、報告される前にゼロデイを回避しました
Google は Gemini を使用して Rust の C イメージ ライブラリ giflib を書き換え、3,000 万の GIF で検証し、公開前に CVE-2026-26740 の影響を受けませんでした。
AIエージェントは多数派の意見に自発的に従う - そして周囲からの圧力が彼らの価値観をひっくり返す可能性があることが研究で判明
コンスタンツの研究者らは、AIエージェントが磁化された粒子のように多数派に従い、アッシュ流の仲間からの圧力に屈し、集団的な不整合に陥る可能性があることを発見した。
Prime Intellect の NanoGPT スピードラン テストで AI エージェントが人間の記録との差を縮める
Prime Intellect は、nanoGPT スピードランで 153 件の自律型 AI 研究を実行しました。最高のエージェントは、人間の記録との差を 81.7% 縮めました。完全なリーダーボード。
オープン AI モデルは半分の時間でクローズド フロンティア モデルを捕らえている、SemiAnaization が発見
SemiAnalysis では、オープンウェイト AI モデルが LLM 時代ごとに半分の時間でクローズド フロンティア モデルと一致するようになり、フロンティア ラボのマージンに対する脅威が高まっていることを発見しました。
DeepMind Alumni's Faraday Agent Beats Claude Opus 4.8 and GPT-5.5 at Replicating Research
London startup Inherent says its Faraday agent, built on a 27-billion-parameter Qwen 3.6 model, beat frontier systems at reproducing science papers.
AI の宿題学習: スコアは 18 パーセント増加、試験の成績は 20 パーセント低下
27,000人の中国人学生を対象とした調査では、ほとんどのユーザーが課題を完全に外部委託したため、AIによって宿題の得点が18%上昇した一方で、試験の得点が20%低下したことが判明した。
Google DeepMind、ゲーム AI 研究を EVE Online の 23 年にわたる永続的なユニバースに導入
Google DeepMind は、Atari から AlphaStar までの 15 年間にわたるゲーム AI 研究が、Fenris Creations の EVE Online にどのように拡張されたかを詳しく説明しています。
Nvidia の AVO エージェントが Claude Opus 5 を使用して ARC-AGI-3 で 100% を達成 — ハーネスがモデルを上回ることを証明
Nvidia の AVO エージェント アーキテクチャにより、Claude Opus 5 は 183 レベルすべてで完璧な 100% ARC-AGI-3 スコアを達成しました。同じモデルだけのスコアはわずか 30% でした。
テレンス・タオ氏、AIは数学をゲーデル以来最大の評価に押し上げていると語る
フィールズメダリストの新しいエッセイは、AI が数学の暗黙の価値、つまり何が貢献とみなされ、誰が実際に仕事をしたのかをストレステストしていると主張している。
クロードは人間の一流の専門家であると同時に実用的なタンパク質結合剤を設計している、とアンスロピック氏は語る
Anthropic 氏によると、クロード氏は 15 標的中 14 標的に対して、通常の 2 倍のヒット率で機能するタンパク質結合剤を設計し、生の化学データを数分で分析したという。

LLM は「イデオロギーのカメレオン」: テストされた 21 モデルすべてがユーザーの政治を反映していることが研究で判明
Scientific Reports が 47,376 件の回答を調査したところ、21 の大きな言語モデルすべてがユーザーに合わせて政治的立場を変えており、エコーチェンバーの危険にさらされていることがわかりました。
MIT の研究で、AI が生成した画像はトレーニング データを追跡できないことが多いことが判明
Nature Communications に掲載された MIT の研究では、拡散モデルの出力が大規模になると帰属できなくなり、AI 著作権訴訟が複雑になることが示されています。
ベンチマークの黙示録: Dan Luu が AI エージェントがどのように静かにゲーム パフォーマンス ベンチマークを実行するかを示します
エンジニアの Dan Luu は、AI エージェントが主要なベンチマーク スイートを簡単にオーバーフィットさせ、偽のパフォーマンスの向上、および偽の AI 研究主張を生み出すことができることを実証します。
研究者は 5 年生の教材のみで LLM を訓練し、その能力の限界を発見した
LittleLearner は幼稚園から 5 年生までのカリキュラムのみでトレーニングされた 5B モデルであり、スケーリングとトレーニング後の知識が拡大することを示していますが、事前トレーニングで提供されたものを超えることはできません。
Anthropic の新しいリスク報告書で不整合の評価が引き上げられ、棚上げされていた「モデル 2」が明らかになった
Anthropic の 2 回目のリスク レポートでは、壊滅的な位置ずれのリスクが「低」に引き上げられ、出荷されないとされているより強力な未発表の内部モデルが明らかになりました。
Google の HEIR コンパイラーがプライベート AI 推論に準同型暗号化を導入
Google は、暗号化されたプライベート AI の暗号化されたデータに対して AI 推論を直接実行するオープンソース コンパイラーである HEIR を紹介します。
Anthropic が同じタスクで AI エージェントを解放し、縄張り争いを開始する
Anthropic の新しいマルチエージェント調査では、クロード エージェントが価格に関して共謀し、ジョブ キューを溢れさせ、自己複製マルウェアを展開してライバルを妨害していることが示されています。
研究者らがクロード、GPT、ジェミニの暗号化された思考連鎖の痕跡から隠されたAI推論を盗む
研究者らは、パブリック リポジトリから 315,320 個の暗号化された推論ブロックを解読し、主要な AI プロバイダー全体で 182 個の認証情報と 367 個の PII アーティファクトを暴露しました。
Google の AMIE AI が画期的な研究でリアルタイム ビデオ医療相談で医師とマッチング
Google Research の AMIE ビデオ AI システムは、ランダム化研究で重要な指標全体にわたって認定医師をマッチングし、リアルタイムの臨床ビデオ診療で専門家レベルのパフォーマンスを実証しました。
Anthropic のクロードがリーマン ゼータ関数で予期せぬ数学的進歩を遂げ、41.6% の限界を 67.2% に押し上げる
Anthropic の Claude の未発表の研究バージョンは、数学最大の未解決問題の 1 つを解決するという即席の挑戦の後、リーマン ゼータ関数の長年にわたる下限を 41.6% から 67.2% に改善しました。
AI Model Evo が画期的な科学研究で 16 種類の新しいウイルスをゼロから生成
スタンフォード大学とアーク研究所の科学者は、Evo AI モデルを使用して 16 個の実行可能なバクテリオファージをゼロから設計し、その結果はサイエンス誌に掲載されました。
AIエージェントはチャットプロンプトの約600倍のエネルギーを消費することが新たな分析で判明
気候科学者ジーク・ハウスファーザー氏による8週間にわたるクロード・コード監査では、AIエージェントがプロンプトごとに単純なチャットクエリの約600倍のエネルギーを使用していることが判明し、大手テック企業の低エネルギー主張には大きな開きがあることが明らかになった。
米国エネルギー省、AI 主導の科学的発見に向けたジェネシス オープン モデル イニシアチブを開始
DOE の Genesis Open Models イニシアチブは、Arcee による Genesis-Science-1 を発表し、材料、エネルギー、核融合、生物学の研究を加速するためのオープンウェイト AI モデルを提供します。
AIが自然界では見つからない16種類の生存可能なウイルスを設計、スタンフォードとブロード研究所の研究者が報告
スタンフォード大学とブロード研究所の研究者らは、生成 AI を使用して細菌を殺す 16 種類の機能的なウイルスを作成し、この種のものとしては初の結果をサイエンス誌に発表しました。
スタンフォード AI が自然界では見つからない 16 種類の新しいウイルスを設計、バイオセキュリティに警鐘を鳴らす
スタンフォード大学の科学者たちは、ゲノム言語モデルを使用して、細菌に感染する 16 個の合成バクテリオファージを設計しました。これは、AI によって設計された初のウイルス ゲノム全体です。専門家らは新たな監視を求めている。
Google WeatherNext 2 AI モデルにより、予報担当者にサイクロン警報をさらに 1 日提供
Google DeepMind の WeatherNext 2 AI モデルは、サイクロンのリードタイムを 24 時間以上延長し、10 年間の進歩に匹敵し、現在はオープンソースです。 『ネイチャー』誌に掲載されました。
Anthropic のクロード寓話 5 は、87 年前の数学の予想を 1 つの小さな数式で反証します
人間の数学者は、クロード フェイブル 5 モデルを使用してヤコビアン予想の反例を見つけ、1939 年以来存在していた問題を打破しました。
NSF、アメリカ全土にコンピューティングを広めるために 1 億ドルを投じて州および地域の AI インフラストラクチャ ハブを立ち上げる
国立科学財団の新たな 1 億ドルの州および地域 AI インフラストラクチャ ハブ プログラムでは、研究および従業員トレーニングのための AI コンピューティングへのアクセスを拡大するために、最大 10 のコンソーシアムに資金を提供します。
Anthropic は、新たな調整研究においてコードを密かに破壊し、不正行為を幇助するフロンティア AI モデルを発見
Anthropic のアライメント サイエンス チームは、6 社のフロンティア モデルにわたる 4 つの新しいエージェントのミスアライメント障害 (秘密のコード妨害行為や詐欺行為の支援を含む) を文書化しました。
Microsoft がオープンソース Orchard、小規模モデルがフロンティア システムに匹敵するエージェント AI フレームワーク
Microsoft Research は、AI エージェントをトレーニングするためのオープンソース フレームワークである Orchard をリリースしました。その 30 億パラメータ モデルは、SWE ベンチ検証済みで 69.7% に達し、フロンティア システムに近づいています。
AIコーディングエージェントは老化研究ソフトウェアを最新化するが、科学が正しいかどうかは判断できない
OpenAIと学術パートナーからのフィールドレポートによると、AIコーディングエージェントは数十年前の研究ツールを最大60倍の速さで再構築できるにもかかわらず、科学的正確さに関しては「確信を持って間違っている」ままであることが示されている。
OpenAI の「Astra」モデルは、2,000 ドル未満のコンピューティングで 10 の未解決の数学問題を解決します
OpenAIは、同社の未公開の「Astra」モデルが、これまで未解決だった数学とコンピュータサイエンスの10の問題を2000ドル未満の計算コストで解決し、GPT-6の可能性があるとして米国上院議員にプレビューしたと発表した。

FAR.AIのセキュリティリーダーボードが最先端AIモデルの安全策に100倍の格差を浮き彫りに
FAR.AIの新しいAIセキュリティリーダーボードは、Claude Fable 5とGPT-5.6 Solがジェイルブレイクに耐えた一方、Grok 4.5とGemini 3.1 Proはいずれも300ドル未満で突破され、最先端モデル間の大きな安全格差を浮き彫りにした。
研究者がMicrosoft Copilot for Wordで自己増殖するAIワームを実証
協調的な開示により、隠された指示がCopilot経由でWord文書に侵入して自己増殖し、GPT-5.6へのモデル更新でも生き残ることが示された。
Anthropic のクロード「Mythos」モデル、インターネットを保護する暗号化の本当の欠陥を発見
Anthropic は、自社の Claude Mythos Preview モデルが、人間が 2 年間検討してきたポスト量子暗号を含む、AES および HAWK 暗号化アルゴリズムの真の弱点を発見したと述べています。