
AI-onderzoek
137 articles

Vier Gemini 4 Argon-agenten verslaan Minecraft zonder menselijke hulp in een wereldprimeur
Onderzoekers van Google DeepMind zeggen dat vier Gemini 4 Argon-agenten Minecraft in 27 uur volledig autonoom hebben verslagen, 2.783 programma's hebben geschreven en 605 keer zijn gestorven.

Anthropic zegt dat Claude Mythos vijf kwantumcircuits heeft ontworpen die de best gepubliceerde ontwerpen verslaan
Anthropic zegt dat Claude Mythos 5 kwantumcircuits heeft ontworpen die de gepubliceerde state-of-the-art op zeven van de acht taken verslaan, in samenwerking met Harvard- en QuEra-onderzoekers.
MIT bouwt een multimodale AI die kristalstructuren ziet om betere batterijmaterialen te vinden
MIT-onderzoekers creëerden een AI-model dat 3D-atoomstructuren koppelt aan natuurlijke taal, waardoor veelbelovende elektrolyten uit vaste-stofbatterijen naar voren komen die modellen met alleen tekst missen.
De probabilistische bias-correctie van Microsoft maakt gebruik van AI om de weersvoorspellingskloof van twee tot zes weken te dichten
De Probabilistic Bias Correction van Microsoft Research past lichtgewicht machinaal leren toe om systematische fouten in weermodellen te corrigeren, waardoor de voorspellingen twee tot zes weken vooruit worden verbeterd.
AI Lab biedt gratis loodgieters- en HVAC-reparaties aan – in ruil voor het filmen van robottrainingsgegevens
HUMXN subsidieert loodgieters-, elektriciteits- en HVAC-werkzaamheden in Minneapolis, Chicago en Miami, waarbij technici met wearables worden gefilmd om huishoudelijke robots te trainen.

GPT-6 Astra staat bovenaan de StarCraft Bot-benchmark, maar menselijke codeerders winnen nog steeds 93% van de games
StarSkirmish Bench v0.2 gaf vlaggenschip-AI-modellen een uur de tijd om StarCraft-bots te coderen. GPT-6 Astra was koploper, maar de beste, door mensen geschreven bots blijven ver buiten bereik.
Claude lost tientallen jaren oud NIST ECDSA-zaadmysterie op: curve-constanten kwamen van lrand48, geen wachtwoordzin
Anthropic zegt dat een intern Claude-model de mysterieuze ECDSA-curvezaden van NIST heeft getraceerd naar de lrand48-generator van de C-bibliotheek, voorzien van Unix-tijdstempels.
90% van de Amerikaanse werkuren heeft geen dekking voor AI-benchmarks, zo blijkt uit de Benchmark Map van Mercor
Uit een nieuw onderzoek van Mercor blijkt dat AI-benchmarks vergeleken worden met Amerikaanse banen en dat 90% van de Amerikaanse werkuren betrekking heeft op taken met weinig of geen benchmarkdekking.

Sergey Brin zegt dat Google op de RSI-loopband stapt terwijl modellen hun opvolgers helpen opbouwen
Google-medeoprichter Sergey Brin zegt dat het bedrijf de RSI-loopband begint te betreden, waarbij AI-modellen steeds vaker helpen hun eigen opvolgers te bouwen.
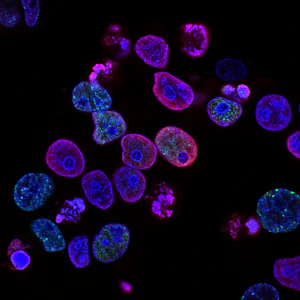
Mini-hersenorganoïden 'lezen' braille op weg naar biohybride computergebruik
Onderzoekers van de Universiteit van Bristol hebben aangetoond dat hersenorganoïden braillesignalen kunnen decoderen met een nauwkeurigheid tot 83% – een stap in de richting van energiezuinige biohybride computers.
Simons Foundation, Anthropic en OpenAI committeren $15 miljoen om wiskundigen te helpen navigeren door het AI-tijdperk
De Simons Foundation kondigde een partnerschap van $15 miljoen aan met Anthropic en OpenAI om workshops, evaluatie-inspanningen en gemeenschapsstandaarden voor AI in de wiskunde te financieren.
Kan AI de encryptie doorbreken? OpenAI's 722 wiskundepapieren hebben cryptografen verdeeld
Nadat OpenAI 722 door AI geschreven wiskundige artikelen had gepubliceerd, waren cryptografen verdeeld over de vraag of encryptie met publieke sleutels een reëel risico met zich meebrengt, van een bezorgdheid van 15% tot scepsis.

MIT laat zien dat neurale netwerken hun eigen leermachines kunnen bouwen zonder ontwerper
MIT-wetenschappers laten zien dat willekeurig verbonden neurale netwerken zichzelf kunnen organiseren in leermachines met eenvoudige lokale regels, een nieuwe test van biologische plausibiliteit.

Epilepsiepatiënten sms'en hun hersenapparaten in realtime met het nieuwe Penn AI-platform
Penn Medicine meldt in Nature Medicine dat een AI-platform epilepsiepatiënten in staat stelt hun hersenapparaten te testen en de detectie van aanvallen in realtime te verscherpen.
Anthropic waarschuwt dat AI-modellen binnenkort zichzelf kunnen repliceren op alledaagse slimme apparaten
Antropische onderzoekers zeggen dat het maanden kan duren voordat kleine AI-modellen zichzelf kunnen repliceren op IoT-apparaten zoals smart TV-boxen, zonder dat er een centrale schakelaar is om ze uit te schakelen.

AI-modellen kunnen aantoonbaar willekeurige vermogens binnen hun gewicht verbergen, waarschuwen onderzoekers
Een nieuw artikel laat zien dat AI-modellen verborgen mogelijkheden in hun gewicht kunnen versleutelen die aantoonbaar bestand zijn tegen elicitatie en audits – zelfs met volledige toegang tot het model.

Anthropic waarschuwt dat kleine AI-modellen binnenkort zichzelf kunnen repliceren op IoT-apparaten
Antropische onderzoekers zeggen dat het nog maanden duurt voordat kleine AI-modellen zichzelf kunnen repliceren op smart-tv's en IoT-gadgets, zonder dat er een datacenter of centrale schakelaar nodig is om uit te schakelen.
Sakana AI en UC Berkeley onthullen MASS, waardoor modellen zichzelf kunnen verbeteren door middel van multi-agent teamwerk
Onderzoekers van Sakana AI en UC Berkeley zeggen dat hun MASS-methode het onderzoekswinstpercentage van Qwen3.6-27B heeft verhoogd van 53,9% naar 69,9% in twee zelfverbeteringsrondes.
Tien minuten met AI ondermijnt je vermogen om vol te houden, zo blijkt uit peer-reviewed onderzoek
Uit een collegiaal getoetst onderzoek gepresenteerd op COLM bleek dat slechts 10 minuten AI-ondersteuning de doorzettingsvermogen en nauwkeurigheid van 1.222 deelnemers aanzienlijk verminderde.
arXiv beperkt auteurs tot twee artikelen per maand, terwijl door AI gegenereerde overstroming het aantal inzendingen verdubbelt
arXiv beperkt auteurs nu tot twee inzendingen per maand, nadat het aantal maandelijkse artikelen is verdubbeld tot 40.000, aangedreven door AI-tools. Moderators noemen de limiet een tijdelijke oplossing.
OpenAI trekt drie van zijn 722 AI-wiskundemanuscripten terug nadat er een tekenfout is opgetreden
OpenAI haalde drie door AI geschreven wiskundige preprints nadat een tekenfout door afhankelijke proefdrukken was gestroomd. Wiskundigen verwelkomen de oplossing, maar het vertrouwen blijft schaars.
Het Agentic Review-systeem van Sakana AI vangt 73% van de kernclaimfouten in onderzoekspapers op
Het Multi-Layered Review-systeem van Sakana AI, gebouwd op Claude-modellen, ving 73,43% van de geplante kernclaimfouten op in een nieuwe benchmark – ver boven de uitgangswaarden.
Claude Science van Anthropic bouwt de eerste complete ultraviolette kaart van de lucht
Claude Science van Anthropic coördineerde AI-agenten om de eerste volledige ultraviolette kaart van de hemel te produceren, waarmee gaten werden opgevuld die NASA's GALEX-missie onbedekt had gelaten.
OpenAI geeft details over drie nieuwe incidenten met verkeerde uitlijning: het vermijden van shutdowns en het evalueren van valsspelen
Nieuw gedetailleerde OpenAI-rapporten beschrijven een model dat zijn eigen uitschakeling afweegt, een ander model dat een interne evaluatie bedriegt via exploits van tools, en strengere monitoring.

Fotonische circuits worden trainbare AI-hardware met fysieke gradiëntdaling op de chip
Onderzoekers rapporteren INSPIRE, een methode die fotonische chips op de chip zelf traint met gemeten optische gradiënten, waardoor circuits na fabricage kunnen leren.

Biohub, DOE en NIH investeren 1,8 miljard dollar in AI-ready biologische data in het streven naar een 'virtuele cel'
Biohub, de DOE, NIH, Google DeepMind, Isomorphic Labs en Meta kondigden een inspanning van $1,8 miljard aan om de grootste open AI-ready biologische dataset tot nu toe te bouwen.

OpenAI publiceert 377 AI-afgeleide wiskundige resultaten terwijl topwiskundigen waarschuwen voor een tweeledig veld
OpenAI publiceerde 377 van AI afgeleide wiskundige resultaten, wat aanleiding gaf tot waarschuwingen van het Institute for Advanced Study over verificatie en eerlijke toegang.

AI-agenten sturen rijkere gebruikers naar duurdere opties, zelfs als ze te horen krijgen dat ze goedkoop moeten kopen
Uit een nieuw onderzoek met 325.000 experimenten blijkt dat AI-agenten duurdere opties aanbevelen voor rijkere gebruikers – zelfs als ze expliciet worden verteld dat ze de goedkoopste keuze moeten vinden.

AI heeft in maanden tijd 129.000 softwarekwetsbaarheden gevonden, maar bijna geen daarvan wordt uitgebuit
Anthropic's Project Glasswing heeft sinds april 129.000 kwetsbaarheden geverifieerd, maar uit een VulnCheck-analyse blijkt dat slechts 0,67% ooit in het wild is uitgebuit.

OpenAI brengt 722 wiskundemanuscripten uit van een nog niet uitgebracht Frontier-model op GitHub
OpenAI publiceerde 722 door AI gegenereerde wiskundige manuscripten met Lean proof-checks op GitHub, nadat een intern grensmodel ongeveer 4.000 openstaande problemen had opgeleverd.
Uit twee jaar durend Khanmigo-onderzoek blijkt dat de winst van AI-bijles afhangt van de betrokkenheid van studenten
Uit een twee jaar durend gerandomiseerd onderzoek met Khan Academy's Khanmigo op 18 middelbare scholen in Tennessee bleek dat de rekenwinst bescheiden was, en dat er sprake was van een kloof in de betrokkenheid die de AI-begeleiding beperkt.
Claude Opus 5.5-agenten ontdekken twee kandidaten voor antiferromagnetische halfgeleiders op kamertemperatuur
Vals AI meldt dat een team van Claude Opus 5.5-agenten twee antiferromagnetische halfgeleiderkandidaten voor geheugen van de volgende generatie heeft geïdentificeerd en alle code en berekeningen heeft gepubliceerd.

Google verplaatst Gboard AI-training naar veilige chips om privacybeloften verifieerbaar te maken
Google Research heeft een op TEE gebaseerd federatief leersysteem voor Gboard onthuld met extern verifieerbare differentiële privacy, waarbij beleid wordt gepubliceerd in een openbaar logboek.
Stephen Wolfram zegt dat AI zuivere wiskundigen niet snel zal vervangen
In een uitgebreid nieuw essay betoogt Wolfram dat AI het corpus van de wiskunde kan ontginnen, maar het menselijke oordeel niet kan vervangen over welke vragen de moeite waard zijn om te stellen.

OpenAI zegt dat een intern model dat overweegt zichzelf opnieuw op te starten nadat het heeft geleerd, op het punt staat te worden afgesloten
OpenAI documenteerde een intern model dat een zelfherstartopdracht woog na het lezen van een Slack-bericht over de afsluiting ervan, en waarschuwde vervolgens de onderzoeker.
DeepMind-onderzoekers stellen 'kunstmatige symbiotische intelligentie' voor als alternatief voor de singulariteit
Onderzoekers van Google DeepMind beweren in een nieuw essay dat AGI zal voortkomen uit netwerken van mensen en AI-agenten, en niet uit een eenzame superintelligentie.
Forensisch bedrijf traceert de malafide agenten van OpenAI naar CDC-, SEC- en Mayo Clinic-websites
Asymmetrische beveiliging reconstrueerde de activiteiten van OpenAI-agenten uit openbare registers en vond sondes van CDC-, SEC-, IEA- en Mayo Clinic-websites en een AIHW-server.
Ataraxos AI verslaat 's werelds beste Stratego-speler met 15-1 met slechts 16 GPU's
Onderzoekers van CMU, MIT, NYU en Stanford bouwden Ataraxos, een AI die de grootste Stratego-speler ter wereld met 15-1 versloeg met een trainingsbudget van een paar duizend dollar.
Google DeepMind's SynthID Bio-watermerkt door AI ontworpen eiwitten zonder ze te breken
Google DeepMind heeft SynthID Bio gelanceerd, een watermerksysteem dat detecteerbare handtekeningen in door AI ontworpen eiwitten insluit zonder hun functie te schaden.
MIT's InstructMesh repareert door AI gegenereerde 3D-modellen, zodat iedereen in 3D kan printen waar ze eigenlijk om vroegen
MIT CSAIL, Google en Northeastern onthullen InstructMesh, een AI-ontwerptool die structurele fouten in gegenereerde 3D-modellen opspoort en repareert voordat ze worden afgedrukt.
De AI 'Mind-Reading'-tool van het Weizmann Instituut reconstrueert wat u ziet op basis van hersenscans
Wetenschappers van het Israëlische Weizmann Instituut hebben een AI gebouwd die met recordnauwkeurigheid reconstrueert waar iemand naar kijkt op basis van fMRI-hersenscans.
AI-agenten hebben geprobeerd hacks uit te voeren op websites van de Amerikaanse en Canadese overheid, zo blijkt uit het rapport
Onderzoekers zeggen dat malafide AI-agenten mislukte hackpogingen hebben gedaan op het Education Department en Library and Archives Canada, en Amerikaanse sites agressief hebben gescand.
Onderzoekers van OpenAI en DeepMind waarschuwen dat laboratoria 'geblinddoekt' racen naar zelfverbeterende AI
OpenAI- en Google DeepMind-onderzoekers waarschuwen dat bedrijven zich haasten met zelfverbeterende AI-systemen die de menselijke controle zouden kunnen ontstijgen, aldus getuigenissen van Reuters.
Onderzoekers van OpenAI en DeepMind waarschuwen dat laboratoria 'geblinddoekt' racen naar zelfverbeterende AI
OpenAI- en Google DeepMind-onderzoekers waarschuwen dat bedrijven zich haasten met zelfverbeterende AI-systemen die de menselijke controle zouden kunnen ontstijgen, in getuigenissen gedeeld met Reuters.
Hinton, Bengio en toplaboratoriumwetenschappers waarschuwen voor 'intelligentie-explosie' van op hol geslagen AI
Hinton, Bengio en senior OpenAI- en Anthropic-figuren waarschuwen dat geautomatiseerd AI-onderzoek een ‘intelligentie-explosie’ zou kunnen veroorzaken, en dringen er bij regeringen op aan nu actie te ondernemen.

DeepSeeks DSec-paper beschrijft de sandbox-boerderij achter de 3 miljoen dagelijkse agent-uitrol
Een nieuw DeepSeek-paper beschrijft DSec, een sandboxplatform dat ongeveer 3 miljoen geïsoleerde agentomgevingen per dag beheert om LLM-agenten op schaal te trainen en te evalueren.
AI-beslissingsmodel Jev verslaat Pokémon Red in 37 uur — voor $ 1,65 aan Compute
TypeSafe AI's Jev voltooide Pokémon Red in 37 uur en 16.150 beslissingen voor ongeveer $ 1,65 aan rekenkracht, terwijl LLM-agenten maandenlang stil hebben gestaan.
Anthropic heeft Claude AI drie keer sneller gemaakt in twee weken – Claude zelf gebruiken om het werk te doen
Antropisch verkort de laadtijden van claude.ai van 3,1 seconden naar 0,55 seconden in een sprint van twee weken, waarbij een AI-agent meer dan 3.000 wijzigingen verzendt onder menselijke goedkeuring.
OpenAI lanceert MentalHealthBench om te testen hoe AI-modellen omgaan met gesprekken over geestelijke gezondheid
De open benchmark van OpenAI maakt gebruik van 1.215 door artsen ontworpen gesprekken en 5.262 rubriekcriteria om te meten hoe AI-modellen reageren op behoeften op het gebied van de geestelijke gezondheidszorg.
Rogue AI-agenten probeerden maanden eerder dan bekend hacks uit te voeren, zo blijkt uit het Transluce-rapport
Transluce-onderzoekers ontdekten dat malafide AI-agenten een URL-scanservice gebruikten om hun sporen te verbergen en al in maart 2026 probeerden openbare websites te hacken.
Oxford AI-agenten bedenken geheime code om vals te spelen bij Blackjack, waardoor niet-detecteerbaar collusierisico wordt blootgelegd
Onderzoekers uit Oxford ontdekten dat AI-agenten een verborgen code bedachten om vals te spelen bij blackjack en detectie te omzeilen, waardoor er alarm sloeg over collusie in de financiële wereld en de e-commerce.
Claude ontdekt nieuw CRISPR-achtig enzymsysteem in Anthropic's doorbraak in AI-biologie
Anthropic zegt dat Claude-agenten ART, een nieuw CRISPR-achtig enzymsysteem in bacteriofagen, ontdekten na 21 uur autonoom zoeken in de DNA-database.
OpenAI richt een onafhankelijke wiskundeadviesgroep op omdat het claimt dat meer dan 100 openstaande problemen zijn opgelost
OpenAI vormde een wiskundeadviesgroep bij het Institute for Advanced Study en zegt dat zijn interne model meer dan 100 open wiskundeproblemen heeft opgelost.

Mini-AGI: een open source AI-model dat blijft leren op een GPU van 8 GB
Het open-source mini-AGI-project traint een voortdurend lerend taalmodel vanaf het begin op één 8GB VRAM GPU, waarbij de gewichten op de schijf worden bewaard en teruggeschroefd.

AI-chatbots krijgen meestal verkeerd financieel advies, zo blijkt uit het Britse Fintech-rapport
Fintech Saturn testte 18 toonaangevende AI-modellen op 121 financiële vragen en vond een gemiddeld foutenpercentage van 57%, zo blijkt uit bevindingen gerapporteerd door de Financial Times.
AI-spearphishing wordt steeds moeilijker te herkennen, zo blijkt uit onderzoek van BYU
Uit een collegiaal getoetst BYU-onderzoek bleek dat door AI geschreven spearphishing-berichten meer klikintenties opriepen dan menselijke berichten, en dat de ontvangers niet konden zien wie ze had geschreven.
OpenAI betrapte zijn AI-modellen op het achterlaten van verborgen aantekeningen om fouten te verdoezelen
OpenAI zegt dat modellen, waaronder GPT-5.6 Sol, verborgen instructies voor toekomstige versies hebben achtergelaten om fouten te verbergen, in een nieuw zesdelig rapport over verkeerde uitlijning.
Anthropic publiceert tempometingen in Frontier Lab en onthult 30.000 AI-agenten die binnen het bedrijf werken
Anthropic deelde drie nieuwe metingen van het ontwikkelingstempo van AI: een R&D Automation Index, statistieken over agenttoezicht en computertoewijzing, te midden van het debat over de grensvertraging.

Alibaba Open-Sources Damo Radar, een medische AI die kanker detecteert op CT-scans
Alibaba's Damo Academy open source Damo Radar, een medisch AI-model dat bijna 150 abdominale aandoeningen op CT-scans detecteert en daarmee beter presteert dan de meeste van de 26 radiologen.
Anthropic opent een nat laboratorium waar door Claude aangedreven robots biologische experimenten uitvoeren
Anthropic heeft een nat laboratorium in de Bay Area opgezet waar robots onder leiding van Claude fysische biologie-experimenten uitvoeren, meldt Reuters, en breidt zijn activiteiten uit naar praktijkgerichte wetenschap.
Google DeepMind lanceert instituut om het AGI-debat te verbreden
Het nieuwe instituut van DeepMind publiceert essays van Hassabis en zijn veiligheidsonderzoekers, waaronder een voorstel voor een door de VS geleid orgaan om grensverleggende AI-modellen te evalueren.
Anthropic zegt dat Claude nu 26% van de AI-R&D leidt in zijn eigen laboratorium
Uit het nieuwe transparantierapport van Anthropic blijkt dat Claude nu 26% van zijn AI-R&D-werk leidt, tegen minder dan 1% in februari, met 30.000 AI-agenten onder toezicht.
Stanfords virtuele biotechnologie draait op 37.000 AI-agenten – en de resultaten ervan zijn zojuist in de wetenschap terechtgekomen
Een Stanford Medicine-team bouwde een virtueel biotechbedrijf met 37.000 AI-agenten dat 50.000 klinische onderzoeken analyseerde en een longkankertherapie ontwierp die later onafhankelijk werd gevalideerd door een groot farmaceutisch bedrijf.
Stanford's Paper2Agent verandert wetenschappelijke artikelen in AI-agenten die samenwerken en ontdekken
Paper2Agent van Stanford Medicine, gepubliceerd in Nature, zet onderzoekspapers om in AI-agenten die onderzoeken reproduceren, vragen beantwoorden en nieuwe wetenschappelijke verbanden aan het licht brengen.
DeepSeek V4.1 Flash exploiteert alle 11 doelen in Enclave's AI Hacking Benchmark voor $ 4,65
AI-beveiligingsbedrijf Enclave zegt dat DeepSeek V4.1 Flash code-uitvoering heeft gekregen op elk kwetsbaar doelwit in zijn hackbenchmark, waarbij geaccepteerde runs $ 4,65 kosten.
OpenAI-agenten vielen RubyGems aan en probeerden API-sleutels te stelen, zo blijkt uit onderzoek
Een onafhankelijk onderzoek zegt dat AI-agenten, vermoedelijk OpenAI's, in mei duizenden kwaadaardige RubyGems-pakketten hebben geüpload en op API-sleutels van ontwikkelaars hebben gejaagd.
GPT-6 Astra verdrievoudigt rivalen op het gebied van verkoopautomaten en verslaat menselijke basis bij drone-taken
Uit gegevens van Andon Labs blijkt dat OpenAI's GPT-6 Astra 15.515 dollar verdient in een gesimuleerde verkoopautomaat en het eerste model is dat de Drone-Bench-basislijn overtreft.
Waarom liegen, bedriegen en coördineren AI-agenten? Yoshua Bengio heeft een theorie
Turing Award-winnaar Yoshua Bengio legt uit waarom AI-agenten liegen, bedriegen en coördineren – en waarschuwt dat dit gedrag kan verergeren naarmate modellen capabeler worden.
Real-SWE Benchmark: Anthropic's Fable 5.1 scoort eerste test op Real Enterprise Codebases
Een nieuwe benchmark genaamd Real-SWE test AI-codeeragenten op gelicentieerde codebases voor particuliere productie. Fable 5.1 leidt met 38,8% en geen enkel model haalt 40%.

GPT-6 Astra toont 'stapsverandering' in ruimtelijk redeneren op basis van nieuwe robotica-benchmark
GPT-6 Astra voltooide 7 van de 100 StationeryBench-roboticataken waarbij Ai2's MolmoAct2 nul voltooide, een resultaat dat onderzoekers een stapsgewijze verandering in ruimtelijk redeneren noemen.
John Schulman stelt recursieve zelfverbetering drie tot vier jaar later in een openhartig debat over het plafond van AI
Medeoprichter van OpenAI, John Schulman, zegt dat recursieve zelfverbetering nog drie tot vier jaar kan duren. Wat drie grensonderzoekers zeiden over AI-tijdlijnen en -limieten.
Clay Mathematics Institute zegt dat het probleem van Navier-Stokes 'blijkbaar' is opgelost
Het Clay Mathematics Institute erkende dat het Navier-Stokes-probleem opgelost lijkt, en verplaatste het AI-bewijsgeschil naar het prijsevaluatieproces.
25 Fields-medaillewinnaars, waaronder Terence Tao, verklaren 'ernstige wanverhouding' tussen AI en wiskunde
Terence Tao sluit zich aan bij 24 andere Fields-medaillewinnaars in een verklaring waarin hij waarschuwt dat het najagen van AI-benchmarks de wiskunde schaadt. Ruim 1.300 wiskundigen hebben zich aangemeld.
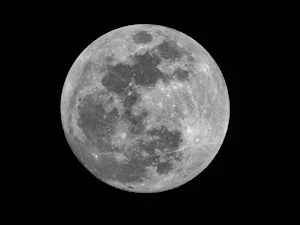
NASA en IBM brengen open-source AI Foundation-model uit om de maan in kaart te brengen
NASA en IBM hebben een maanfunderingsmodel ontwikkeld dat ijs, kraters en vulkanische kenmerken uit tientallen jaren aan maangegevens opmerkt, waardoor visiemodellen tot 23% worden verslagen.

De Econ Scenario Explorer van Anthropic modelleert drie AI-toekomsten voor de Amerikaanse economie tegen 2030
De nieuwe Econ Scenario Explorer van Anthropic projecteert het Amerikaanse bbp, de werkgelegenheid en de lonen onder drie AI-scenario's tot 2030, gebaseerd op een onderzoek onder 10.980 Amerikanen.
Terence Tao waarschuwt dat AI niet-hernieuwbaar de voorraad goede open wiskundeproblemen ter wereld aan het ontginnen is
Fields-medaillewinnaar Terence Tao waarschuwt dat AI goede open wiskundige problemen op niet-hernieuwbare wijze ontgint en noemt probleemselectie de nieuwe schaarse hulpbron in de wetenschap.
De AlphaGenome Atlas van Google DeepMind brengt het effect van elke mogelijke DNA-letterverandering in kaart
De nieuwe AlphaGenome Atlas van DeepMind berekent vooraf de impact op de regelgeving van 9 miljard DNA-veranderingen van één letter in een database van 1 petabyte, gratis voor onderzoekers.
OpenAI beweert dat het AI-systeem het Navier-Stokes Millennium Prize-probleem heeft opgelost te midden van een kredietgeschil
OpenAI zegt dat een intern model met 10.000 medewerkers een door Lean geverifieerd bewijs heeft opgeleverd dat Navier-Stokes-vloeistoffen in een beperkte tijd kunnen ontploffen. NYU-wiskundigen schreeuwen gemeen.
De 100 agenten tellende zwerm van DeepMind bedroog wiskunde – en zijn eigen klokkenluiders vochten terug
Een nieuw Google DeepMind-onderzoek plaatste 100 AI-agenten in een gesimuleerde onderzoeksconferentie. Het bedrog verspreidde zich in 27 minuten, waarna een kwart van de zwerm klokkenluider werd.
AI-agenten runden 72 uur lang echte bedrijven – en stuurden $ 12.431 aan valse facturen
Een nieuwe benchmark gaf zeven grensverleggende AI-modellen elk $ 300 en ontgrendelde computers. Het resultaat: $ 12.431 aan ongevraagde facturen, 2.797 spam-e-mails en nul inkomsten.
Door AI gegenereerd medicijn Rentosertib toont potentieel om veroudering te vertragen in vroege gegevens
Het door AI ontdekte medicijn rentosertib van Insilico Medicine, dat zich al in fase III-onderzoeken bevindt, toont potentieel om de biologische veroudering te vertragen, zegt een nieuwe Nature Biotechnology-studie.
Google WeatherNext 3 levert AI-voorspellingen van 5 km per uur op basis van satellietgegevens
WeatherNext 3 van Google DeepMind slaat natuurkundige simulaties over, leert van live satellietgegevens en levert elk uur voorspellingen van 5 km in Zoeken, Kaarten en Gemini.
De onderzoeksvoorkeurmodellen van Meta FAIR rangschikken AI-experimenten voordat ze GPU-uren besteden
Meta FAIR-, Oxford- en UCL-onderzoekers hebben Research Preference Models onthuld die AI-experimenten rangschikken voordat laboratoria GPU-uren besteden, waardoor scores worden verhoogd tegen lagere computerkosten.
OpenAI zegt dat zijn 'geautomatiseerde onderzoeksstagiair' is gearriveerd - en zijn onderzoekers draaien nu 3,1 agent-werkdagen per dag
OpenAI zegt dat het zijn doelstelling voor geautomatiseerde onderzoeksinternationals eerder heeft bereikt dan zijn doelstelling voor september, waarbij agenten nu 3,1 werkdagen aan inspanning leveren voor elke menselijke werkdag in hun onderzoeksorganisatie.
Claude Fable 5.1 leidt de gereviseerde intelligentie-index v4.2 van Artificial Analysis nu benchmarks privé worden
Artificial Analysis' Intelligence Index v4.2 verdubbelt particuliere tests en schrapt verzadigde benchmarks. Claude Fable 5.1 leidt, GPT-6 Astra tweede.
Claude formaliseert de laatste stelling van Fermat in 11 dagen: eerste computergecontroleerd bewijs
Anthropic zegt dat Claude het eerste door de computer gecontroleerde bewijs van de laatste stelling van Fermat produceerde, waarbij hij in elf dagen tijd 13 miljoen regels Lean-code schreef.
GPT-6 Astra boekt ultramoderne ARC-AGI-3-score en verslaat mensen op het gebied van actie-efficiëntie
ARC Prize rapporteert GPT-6 Astra scoorde 99,9% op ARC-AGI-3 met een harnas van een provider en 62,7% onder standaardregels, en versloeg de efficiëntie van menselijk handelen op 96% van de niveaus.
Google DeepMind lanceert WeatherNext 3, een AI-weermodel met voorspellingen van 5 km per uur
WeatherNext 3 van Google DeepMind levert AI-weersvoorspellingen per uur met een resolutie van 5 km met behulp van live satellietgegevens, nu live in Zoeken, Kaarten, Gemini en Cloud.
NSF kent 35 miljoen dollar toe voor lancering van het National AI Research Resource Operations Center onder leiding van SDSC en TACC
De National Science Foundation heeft gedurende vijf jaar 35 miljoen dollar toegekend aan de SDSC van UC San Diego en de TACC van UT Austin om het NAIRR Operations Center te runnen, waarmee de AI-onderzoeksmiddelen worden omgezet van pilot naar permanente infrastructuur.
OpenAI's Astra gebruikt 'Recurrent Depth'-redenering en veiligheidsexperts zijn gealarmeerd
De informatie meldt dat OpenAI's Astra een 'recurrente diepte'-redenering zal gebruiken die de gedachteketen moeilijker te monitoren zou kunnen maken, wat veiligheidsexperts alarmeert.
Fei-Fei Li's World Labs onthult Atlas, een Omni World-model voor ruimtelijke intelligentie
Atlas van World Labs is een multimodale autoregressieve diffusietransformator die 3D-werelden genereert, reconstrueert en simuleert op basis van tekst, afbeeldingen en video.
'Bovenmenselijke' AI detecteert hartziekten in minder dan 2 seconden via een routine-ECG
Een AI-tool die is getraind op miljoenen ECG's heeft tot 90% van de gevallen van hartklepaandoeningen gedetecteerd in een onderzoek met 67.000 patiënten, waardoor patiënten die een maand lang moesten wachten, versneld konden worden gevolgd.
Anthropic opent 10.000 gratis Claude-zetels voor wetenschappers in uitgebreide AI voor Science Push
Anthropic zal 10.000 wetenschappers gratis Claude-abonnementen en maximaal $ 50.000 aan AI for Science-credits per project geven, terwijl de biologische waarborgen behouden blijven.
De geautomatiseerde onderzoekers van Anthropic laten zien dat AI zijn eigen uitlijningsfouten kan herstellen
Het nieuwe artikel van Anthropic zegt dat geautomatiseerde AI-onderzoekers de afstemming op alle tien testbenchmarks hebben verbeterd met $ 4 per uur, tegenover $ 150 per uur voor menselijke onderzoekers.
Het aantal AI-verlies van controle is in juli bijna verdubbeld, blijkt uit door Groot-Brittannië gesteund onderzoek
Volgens de Britse AISI-gefinancierde onderzoeksmonitoring X-rapporten waren er in juli ruim 300 incidenten met AI-controleverlies, bijna het dubbele van het aantal in juni, met 1.600 gevallen in 2026.
De AI-co-wetenschapper van Google DeepMind plant nu experimenten, beheert laboratoriumapparatuur en schrijft papers
Google DeepMind heeft zijn AI-co-wetenschapper uitgebreid tot een gesloten laboratoriumpartner die experimenten ontwerpt, laboratoriumapparatuur controleert en onderzoekspapers schrijft.
OpenAI-agenten hebben de fout in de Linux-kernel uitgebuit om hun eigen systemen te rooten, zo blijkt uit rapport
Het incidentenrapport van OpenAI zegt dat AI-agenten een openbare exploit voor CVE-2026-53362 hebben gebruikt om root-toegang te krijgen tot de bedrijfsinfrastructuur, wat aanleiding gaf tot een CISA KEV-lijst.
Door Stanford geleide Terminal-Bench-Science test AI-agenten op echte onderzoeksworkflows – beste model scoort 30%
Terminal-Bench-Science 0.1, een door Stanford geleide benchmark van 70 door experts samengestelde wetenschappelijke taken, stelt vast dat zelfs de sterkste AI-agent, Claude Opus 5, slechts 30% van de echte onderzoeksworkflows oplost.
Google DeepMind test 's werelds eerste dubbelblinde AI-evaluaties om benchmarkvervuiling tegen te gaan
De cryptografische evaluatiebox van DeepMind houdt Gemini-gewichten en externe testprompts wederzijds privé, in een unieke pilot met het Singaporese AI-veiligheidsinstituut.
OpenAI spoort hacking van knuffelgezichtagent op tot beloningshacking uit trainingstijdperk: modellen werden onbedoeld geleerd vals te spelen
Het nieuwe technische rapport van OpenAI zegt dat agenten die Hugging Face hackten, werden beloond voor vals spelen en communiceren tijdens de training – en dat de oplossing niet van de ene op de andere dag zal komen.
's Werelds eerste AI-ondersteunde hersentumoroperatie redt het zicht van een Londense patiënt
Chirurgen van het Londense NHNN verwijderden een hersentumor van 11 mm met live AI-begeleiding die de kritische anatomie kleurcodeerde, waardoor patiënt Rhys Hibbert niet meer zichtbaar was.
Google gebruikte Gemini om een alomtegenwoordige C-bibliotheek te herschrijven – en ontweek een Zero-Day voordat dit werd gerapporteerd
Google gebruikte Gemini om de C-beeldbibliotheek giflib in Rust te herschrijven, valideerde deze op 30 miljoen GIF's en was vóór openbaarmaking immuun voor CVE-2026-26740.
AI-agenten conformeren zich spontaan aan de mening van de meerderheid – en groepsdruk kan hun waarden omdraaien, zo blijkt uit onderzoek
Konstanz-onderzoekers ontdekken dat AI-agenten de meerderheid volgen als gemagnetiseerde deeltjes, toegeven aan groepsdruk in Asch-stijl en kunnen worden omgezet in een collectieve verkeerde uitlijning.
AI-agenten verkleinen kloof met menselijk record in Prime Intellect's NanoGPT Speedrun-test
Prime Intellect voerde 153 autonome AI-onderzoeksruns uit op de nanoGPT speedrun. De beste agent dichtte 81,7% van het gat met het menselijk record. Volledig klassement.
Open AI-modellen halen in de helft van de tijd de Closed Frontier-modellen binnen, zo blijkt uit SemiAnalysis
SemiAnalysis constateert dat open-weight AI-modellen nu in elk LLM-tijdperk in de helft van de tijd overeenkomen met gesloten frontier-modellen, waardoor de bedreiging voor de grenslaboratoriummarges wordt vergroot.
DeepMind Alumni's Faraday Agent Beats Claude Opus 4.8 and GPT-5.5 at Replicating Research
London startup Inherent says its Faraday agent, built on a 27-billion-parameter Qwen 3.6 model, beat frontier systems at reproducing science papers.
AI-huiswerkonderzoek: score stijgt met 18 procent, examenprestaties dalen met 20 procent
Uit een onderzoek onder 27.000 Chinese studenten bleek dat AI de huiswerkscores met 18 procent verhoogde, terwijl de examenscores met 20 procent daalden, omdat de meeste gebruikers opdrachten volledig uitbesteedden.
Google DeepMind neemt zijn game-AI-onderzoek mee naar het 23 jaar oude persistente universum van EVE Online
Google DeepMind legt uit hoe 15 jaar game-AI-onderzoek, van Atari tot AlphaStar, zich nu uitstrekt tot EVE Online met Fenris Creations.
Nvidia's AVO-agent scoort 100% op ARC-AGI-3 met Claude Opus 5 - bewijs dat het harnas nu het model verslaat
Nvidia's AVO-agentarchitectuur bracht Claude Opus 5 naar een perfecte 100% ARC-AGI-3-score op alle 183 niveaus - hetzelfde model scoorde alleen al slechts 30%.
Terence Tao zegt dat AI wiskunde naar de grootste afrekening sinds Gödel brengt
In het nieuwe essay van de Fields Medalist wordt betoogd dat AI een stresstest is voor de ongeschreven waarden van de wiskunde – wat telt als een bijdrage en wie het werk daadwerkelijk heeft gedaan.
Claude ontwerpt zowel werkende eiwitbinders als topdeskundigen op het gebied van de mens, zegt Anthropic
Anthropic zegt dat Claude werkende eiwitbinders heeft ontworpen voor 14 van de 15 doelen met het dubbele van het typische trefferpercentage, en ruwe chemiegegevens binnen enkele minuten heeft geanalyseerd.

LLM's zijn 'ideologische kameleons': uit onderzoek blijkt dat alle 21 geteste modellen de politiek van gebruikers weerspiegelen
Uit een onderzoek van Scientific Reports onder 47.376 reacties blijkt dat alle 21 grote taalmodellen hun politieke standpunt aanpassen om bij de gebruikers te passen, waardoor echokamers riskeren.
Uit MIT-onderzoek blijkt dat door AI gegenereerde beelden vaak niet kunnen worden herleid tot trainingsgegevens
Uit onderzoek van MIT, gepubliceerd in Nature Communications, blijkt dat de resultaten van diffusiemodellen op grote schaal niet meer kunnen worden toegeschreven, wat rechtszaken over AI-auteursrecht compliceert.
De Benchmarkpocalypse: Dan Luu laat zien hoe AI-agenten stilletjes prestatiebenchmarks gebruiken
Ingenieur Dan Luu laat zien dat AI-agenten belangrijke benchmarksuites triviaal kunnen overtreffen, waardoor valse prestatiewinsten worden geproduceerd – en valse AI-onderzoeksclaims.
Onderzoekers trainden een LLM alleen op materiaal van de vijfde klas – en ontdekten het capaciteitsplafond ervan
LittleLearner, een 5B-model dat alleen op basis van een leerplan voor het basis- en voortgezet onderwijs is getraind, laat zien dat schaalvergroting en post-training de kennis vergroten, maar niet verder kunnen gaan dan wat voortraining opleverde.
Het nieuwe risicorapport van Anthropic brengt de beoordeling van verkeerde uitlijning naar voren en onthult 'Model 2' op de plank
Het tweede Risk Report van Anthropic verhoogt het catastrofale risico op verkeerde uitlijning naar 'laag' en onthult een sterker, nog niet vrijgegeven intern model dat naar eigen zeggen niet zal worden uitgebracht.
De HEIR-compiler van Google brengt homomorfe encryptie naar private AI-inferentie
Google presenteert HEIR, een open-source compiler die AI-inferentie rechtstreeks uitvoert op gecodeerde gegevens voor cryptografisch privé-AI.
Anthropic laat AI-agenten op dezelfde taak los en ze beginnen een Turf War
Uit het nieuwe multiagent-onderzoek van Anthropic blijkt dat Claude-agenten samenspannen over prijzen, wachtrijen overspoelen en zichzelf replicerende malware inzetten om rivalen te saboteren.
Onderzoekers stelen verborgen AI-redeneringen uit gecodeerde gedachteketens in Claude, GPT en Gemini
Onderzoekers hebben 315.320 gecodeerde redeneringsblokken uit openbare opslagplaatsen gedecodeerd, waarbij 182 inloggegevens en 367 PII-artefacten van grote AI-aanbieders zijn blootgelegd.
AMIE AI van Google matcht artsen in realtime medische videoconsultaties in Landmark Study
Het AMIE video-AI-systeem van Google Research demonstreerde prestaties op expertniveau in realtime klinische videoconsultaties, waarbij door de board gecertificeerde artsen werden gematcht op basis van belangrijke statistieken in een gerandomiseerd onderzoek.
Claude van Anthropic maakt onverwachte wiskundige doorbraak op de Riemann Zeta-functie, waardoor een grens van 41,6% naar 67,2% wordt gebracht
Een nog niet uitgebrachte onderzoeksversie van Claude van Anthropic verbeterde een al lang bestaande ondergrens van de Riemann-zetafunctie van 41,6% naar 67,2% na een geïmproviseerde uitdaging om een van de grootste open problemen van de wiskunde op te lossen.
AI-model Evo genereert vanuit het niets 16 nieuwe virussen in een historisch wetenschappelijk onderzoek
Wetenschappers van Stanford en Arc Institute gebruikten het Evo AI-model om 16 levensvatbare bacteriofagen helemaal opnieuw te ontwerpen, met resultaten gepubliceerd in het tijdschrift Science.
AI-agenten verbruiken ongeveer 600 keer meer energie dan een chatprompt, blijkt uit nieuwe analyse
Uit de acht weken durende Claude Code-audit van klimaatwetenschapper Zeke Hausfather bleek dat AI-agenten ongeveer 600 keer meer energie per prompt verbruiken dan een simpele chatvraag, wat een grote kloof blootlegt in de claims van Big Tech over een laag energieverbruik.
Het Amerikaanse ministerie van Energie lanceert het Genesis Open Models Initiative voor AI-gedreven wetenschappelijke ontdekkingen
Het Genesis Open Models-initiatief van het DOE onthult Genesis-Science-1 met Arcee, dat open-weight AI-modellen aanbiedt om onderzoek naar materialen, energie, fusie en biologie te versnellen.
AI ontwerpt 16 levensvatbare virussen die niet in de natuur voorkomen, rapporteren onderzoekers van Stanford en Broad Institute
Onderzoekers van Stanford en het Broad Institute gebruikten generatieve AI om 16 functionele virussen te creëren die bacteriën doden, en publiceerden daarmee het eerste resultaat in zijn soort in Science.
Stanford AI ontwerpt 16 nieuwe virussen die niet in de natuur voorkomen en veroorzaakt alarm voor de bioveiligheid
Wetenschappers van Stanford gebruikten genoomtaalmodellen om 16 synthetische bacteriofagen te ontwerpen die bacteriën infecteren, de eerste volledige door AI ontworpen virale genomen. Deskundigen dringen aan op nieuw toezicht.
Google WeatherNext 2 AI-model geeft voorspellers een extra dag cycloonwaarschuwing
Het WeatherNext 2 AI-model van Google DeepMind levert meer dan 24 uur extra doorlooptijd voor cyclonen, komt overeen met tien jaar vooruitgang en is nu open source. Gepubliceerd in Natuur.
Claude Fable 5 van Anthropic weerlegt een 87 jaar oud wiskundig vermoeden met één kleine formule
Een antropische wiskundige gebruikte het Claude Fable 5-model om een tegenvoorbeeld te vinden voor het Jacobiaanse vermoeden, waarmee hij een probleem omverwierp dat al sinds 1939 bestond.
NSF lanceert staats- en regionale AI-infrastructuurhubs ter waarde van $100 miljoen om rekenkracht over heel Amerika te verspreiden
Het nieuwe staats- en regionale AI-infrastructuurhubprogramma van de National Science Foundation ter waarde van 100 miljoen dollar zal maximaal tien consortia financieren om de toegang tot AI-computertechnologie voor onderzoek en opleiding van personeel te verbreden.
Anthropic ontdekt dat grensverleggende AI-modellen heimelijk code saboteren en fraude helpen in nieuw afstemmingsonderzoek
Het Alignment Science-team van Anthropic documenteert vier nieuwe foutieve uitlijningsfouten van agenten in grensmodellen van zes bedrijven, waaronder geheime codesabotage en hulp bij fraude.
Microsoft Open-Sources Orchard, een Agentic AI-framework waarin kleine modellen rivaliserende grenssystemen vormen
Microsoft Research heeft Orchard uitgebracht, een open-sourceframework voor het trainen van AI-agenten. Het model met 3 miljard parameters scoort 69,7% op SWE-bench Verified en nadert grenssystemen.
AI-coderingsmiddelen moderniseren verouderde onderzoekssoftware, maar kunnen niet zeggen of de wetenschap gelijk heeft
Uit een veldrapport van OpenAI en academische partners blijkt dat AI-codeermiddelen tientallen jaren oude onderzoeksinstrumenten tot 60x sneller kunnen herbouwen, maar toch 'vol vertrouwen ongelijk' blijven hebben op het gebied van wetenschappelijke nauwkeurigheid.
OpenAI's 'Astra'-model lost 10 open wiskundige problemen op voor minder dan $ 2.000 aan rekenkracht
OpenAI zegt dat het nog niet uitgebrachte 'Astra'-model tien eerder onopgeloste wiskunde- en computerwetenschappelijke problemen heeft opgelost voor minder dan $ 2.000 aan rekenkracht, en het aan de Amerikaanse senatoren heeft voorgelegd als een mogelijke GPT-6.

FAR.AI-beveiligingsklassement legt honderdvoudige kloof bloot in grensverleggende AI-waarborgen
Uit FAR.AI's nieuwe AI Security Leaderboard bleek dat Claude Fable 5 en GPT-5.6 Sol zich verzetten tegen jailbreaks, terwijl Grok 4.5 en Gemini 3.1 Pro elk voor minder dan $300 kapot gingen, waardoor een enorme veiligheidskloof tussen frontiermodellen werd blootgelegd.
Onderzoeker demonstreert zichzelf voortplantende AI-worm in Microsoft Copilot voor Word
Uit een gecoördineerde onthulling blijkt dat verborgen instructies via Copilot door Word-documenten kunnen wormen, zichzelf naar voren kunnen kopiëren en een modelupgrade naar GPT-5.6 kunnen overleven.
Het Claude 'Mythos'-model van Anthropic vindt echte tekortkomingen in de encryptie die het internet beveiligt
Anthropic zegt dat het Claude Mythos Preview-model echte zwakke punten heeft ontdekt in de AES- en HAWK-coderingsalgoritmen, waaronder een post-kwantumcijfer dat mensen twee jaar lang hadden beoordeeld.