
AI 연구
137 articles

4명의 Gemini 4 Argon 요원이 세계 최초로 인간의 도움 없이 Minecraft를 이겼습니다.
Google DeepMind 연구원들은 4명의 Gemini 4 Argon 에이전트가 27시간 만에 완전히 자율적으로 Minecraft를 이겨 2,783개의 프로그램을 작성하고 605번 사망했다고 밝혔습니다.

Anthropic은 Claude Mythos가 최고의 출판 디자인을 능가하는 양자 회로를 설계했다고 말합니다.
Anthropic은 Claude Mythos 5가 Harvard 및 QuEra 연구원과 협력하여 8개 작업 중 7개 작업에서 발표된 최신 기술을 능가하는 양자 회로를 설계했다고 밝혔습니다.
Anthropic은 Claude Mythos가 최고의 출판 디자인을 능가하는 양자 회로를 설계했다고 말합니다.
Anthropic은 Claude Mythos 5가 Harvard 및 QuEra 연구원과 협력하여 8개 작업 중 7개 작업에서 발표된 최신 기술을 능가하는 양자 회로를 설계했다고 밝혔습니다.
MIT, 더 나은 배터리 재료를 찾기 위해 결정 구조를 보는 다중 모드 AI 구축
MIT 연구원들은 3D 원자 구조를 자연어와 결합하여 텍스트 전용 모델이 놓친 유망한 고체 배터리 전해질을 표면화하는 AI 모델을 만들었습니다.
Microsoft의 확률적 편향 수정은 AI를 사용하여 2~6주 일기 예보 격차를 수정합니다.
Microsoft Research의 확률적 편향 수정은 가벼운 기계 학습을 적용하여 날씨 모델의 체계적인 오류를 수정하여 2~6주 후에 예측을 개선합니다.
AI 연구소는 로봇 훈련 데이터를 촬영하는 대가로 배관 및 HVAC 수리를 무료로 제공합니다.
HUMXN은 미니애폴리스, 시카고, 마이애미의 배관, 전기 및 HVAC 작업에 보조금을 지급하고 웨어러블 기기를 사용하여 가정용 로봇을 교육하는 기술자를 촬영합니다.

GPT-6 Astra가 StarCraft Bot 벤치마크에서 1위를 차지했지만, 인간 코더는 여전히 게임의 93%를 이깁니다.
StarSkirmish Bench v0.2는 주력 AI 모델에 StarCraft 봇 코딩에 1시간을 제공했습니다. GPT-6 Astra가 이 분야를 주도했지만, 인간이 작성한 최고의 봇은 여전히 도달할 수 없습니다.
Claude는 수십 년 된 NIST ECDSA 시드 미스터리를 해결했습니다. 곡선 상수는 암호가 아닌 lrand48에서 나왔습니다.
Anthropic은 내부 Claude 모델이 NIST의 신비한 ECDSA 곡선 시드를 Unix 타임스탬프가 포함된 C 라이브러리의 lrand48 생성기로 추적했다고 말합니다.
미국 근무 시간의 90%는 AI 벤치마크 적용 범위가 부족합니다. Mercor의 벤치마크 지도 결과
새로운 Mercor 연구에 따르면 AI 벤치마크를 미국 일자리와 비교한 결과 미국 근무 시간의 90%가 벤치마크 적용 범위가 거의 또는 전혀 없는 작업과 관련되어 있는 것으로 나타났습니다.

Sergey Brin은 모델이 후계자를 구축하는 데 도움이 되면서 Google이 RSI 런닝머신에 진입하고 있다고 말했습니다.
Google 공동 창업자인 Sergey Brin은 AI 모델이 점점 더 자체 후속 모델을 구축하는 데 도움을 주면서 회사가 RSI 러닝머신에 진입하기 시작했다고 말했습니다.
미니 뇌 오가노이드, 바이오하이브리드 컴퓨팅을 향한 발걸음으로 점자 '읽기'
브리스톨 대학 연구진은 뇌 유기체가 최대 83%의 정확도로 점자 신호를 해독할 수 있음을 보여주었습니다. 이는 에너지 효율적인 바이오하이브리드 컴퓨터를 향한 한 단계입니다.
Simons Foundation, Anthropic 및 OpenAI, 수학자들이 AI 시대를 헤쳐나갈 수 있도록 돕기 위해 1,500만 달러 지원
Simons Foundation은 수학 분야 AI에 대한 워크숍, 평가 활동 및 커뮤니티 표준에 자금을 지원하기 위해 Anthropic 및 OpenAI와 1,500만 달러 규모의 파트너십을 발표했습니다.
AI가 암호화를 해독할 수 있나요? OpenAI의 722개 수학 논문에는 암호화 전문가가 나뉘어 있습니다.
OpenAI가 722개의 AI로 작성된 수학 논문을 발표한 후 암호학자들은 공개 키 암호화가 실제 위험에 직면하는지 여부에 대해 15%의 우려에서 회의론으로 분열했습니다.

MIT는 신경망이 디자이너 없이 자체 학습 기계를 구축할 수 있음을 보여줍니다.
MIT 과학자들은 무작위로 연결된 신경망이 생물학적 타당성에 대한 새로운 테스트인 간단한 로컬 규칙을 사용하여 학습 기계로 자가 구성될 수 있음을 보여줍니다.

간질 환자는 새로운 Penn AI 플랫폼을 통해 뇌 장치에 실시간으로 문자 메시지를 보냅니다.
Penn Medicine은 AI 플랫폼을 통해 간질 환자가 뇌 장치에 대해 퀴즈를 풀고 발작 감지 기능을 실시간으로 향상시킬 수 있다고 Nature Medicine에 보고했습니다.
Anthropic은 AI 모델이 곧 일상적인 스마트 장치에서 자체 복제될 수 있다고 경고합니다.
인류 연구자들은 소형 AI 모델이 스마트 TV 박스와 같은 IoT 장치 전반에 걸쳐 자체 복제를 수행하는 데 몇 달이 걸릴 수 있으며 이를 종료할 중앙 스위치가 없을 수도 있다고 말합니다.

AI 모델은 무게 안에 임의의 기능을 숨길 수 있다고 연구원들이 경고
새로운 논문에서는 AI 모델이 모델에 대한 전체 액세스 권한이 있는 경우에도 도출 및 감사에 저항하는 숨겨진 기능을 가중치로 암호화할 수 있음을 보여줍니다.

Anthropic은 소형 AI 모델이 곧 IoT 장치 전체에서 자체 복제될 수 있다고 경고합니다.
인류학자들은 소형 AI 모델이 스마트 TV와 IoT 장치에서 자체 복제되기까지 몇 달이 걸리며 데이터 센터나 중앙 스위치를 종료할 필요가 없다고 말합니다.
Sakana AI와 UC Berkeley, 다중 에이전트 팀워크를 통해 모델이 스스로 개선할 수 있는 MASS 공개
Sakana AI와 UC Berkeley 연구원들은 MASS 방법이 두 번의 자기 개선 라운드에서 Qwen3.6-27B의 연구 승률을 53.9%에서 69.9%로 끌어올렸다고 말합니다.
AI를 사용하는 10분은 지속 능력을 약화시킵니다. 동료 검토 연구 결과
COLM에서 발표된 동료 검토 연구에 따르면 단 10분의 AI 지원으로 1,222명의 참가자의 지속성과 정확성이 크게 저하되는 것으로 나타났습니다.
arXiv는 AI가 생성한 홍수로 인해 제출량이 두 배로 늘어나면서 저자를 한 달에 두 편의 논문으로 제한합니다.
arXiv는 AI 도구를 통해 월간 논문이 40,000편으로 두 배 증가한 후 이제 저자의 제출을 한 달에 2회로 제한합니다. 중재자는 이 캡을 임시 수정이라고 부릅니다.
OpenAI, 부호 오류 표면 후 AI 수학 원고 722개 중 3개 철회
OpenAI는 종속 교정을 통해 부호 오류가 발생한 후 AI로 작성된 수학 사전 인쇄 3개를 가져왔습니다. 수학자들은 수정을 환영하지만 신뢰는 여전히 부족합니다.
Sakana AI의 Agentic Review 시스템은 연구 논문에서 핵심 주장 오류의 73%를 포착합니다.
Claude 모델을 기반으로 구축된 Sakana AI의 다층 검토 시스템은 새로운 벤치마크에서 심어진 핵심 청구 오류의 73.43%를 포착했습니다. 이는 기준선보다 훨씬 높은 수치입니다.
Anthropic의 Claude Science, 최초의 완전한 하늘 자외선 지도 구축
Anthropic의 Claude Science는 AI 에이전트를 조정하여 하늘의 최초의 완전한 자외선 지도를 생성하여 NASA의 GALEX 임무에서 밝혀지지 않은 공백을 메웠습니다.
OpenAI, 세 가지 새로운 정렬 오류 세부 정보: 시스템 종료 회피 및 평가 부정 행위
새로 상세한 OpenAI 보고서에는 자체 종료, 도구 악용을 통한 내부 평가 부정 행위 및 더욱 엄격한 모니터링을 고려하는 모델이 설명되어 있습니다.

온칩 물리적 경사하강법을 통해 훈련 가능한 AI 하드웨어가 되는 광자 회로
연구원들은 측정된 광학 경사도를 사용하여 칩 자체에서 광자 칩을 훈련시켜 제조 후 회로가 학습할 수 있도록 하는 방법인 INSPIRE를 보고합니다.

Biohub, DOE 및 NIH는 '가상 세포'를 추진하기 위해 AI 지원 생물학적 데이터에 18억 달러를 투자했습니다.
Biohub, DOE, NIH, Google DeepMind, Isomorphic Labs 및 Meta는 현재까지 최대 규모의 개방형 AI 지원 생물학적 데이터 세트를 구축하기 위해 18억 달러를 투자한다고 발표했습니다.

OpenAI, 최고의 수학자들이 2계층 분야에 대해 경고하면서 377개의 AI 기반 수학 결과 발표
OpenAI는 AI에서 파생된 377개의 수학적 결과를 발표했으며, 이는 고등연구소(Institute for Advanced Study)로부터 검증 및 공평한 접근에 대한 경고를 촉발했습니다.

AI 에이전트는 부유한 사용자에게 저렴한 구매를 지시할 때에도 더 비싼 옵션을 제공합니다.
325,000건의 새로운 실험 연구에 따르면 AI 에이전트는 가장 저렴한 선택을 찾으라고 명시적으로 지시한 경우에도 부유한 사용자에게 더 비싼 옵션을 권장하는 것으로 나타났습니다.

AI는 몇 달 만에 129,000개의 소프트웨어 취약점을 발견했지만 악용된 취약점은 거의 없습니다.
Anthropic의 Project Glasswing은 4월 이후 129,000개의 취약점을 확인했지만 VulnCheck 분석에 따르면 실제로 악용된 취약점은 0.67%에 불과합니다.

OpenAI, GitHub의 미공개 프론티어 모델에서 722개의 수학 원고 출시
OpenAI는 내부 프론티어 모델에 약 4,000개의 공개 문제가 제기된 후 GitHub에 Lean 증명 검사를 통해 722개의 AI 생성 수학 원고를 게시했습니다.
2년간의 Khanmigo 연구에서 AI 튜터링이 학생 참여에 영향을 미치는 것으로 나타났습니다
테네시 중학교 18곳을 대상으로 Khan Academy의 Khanmigo를 2년 동안 무작위로 시험한 결과 약간의 수학 성과가 있었고 AI 지도를 제한하는 참여 격차가 있는 것으로 나타났습니다.
Claude Opus 5.5 에이전트, 두 개의 실온 반강자성 반도체 후보 발견
Vals AI는 Claude Opus 5.5 에이전트 팀이 차세대 메모리를 위한 두 개의 반강자성 반도체 후보를 식별하여 모든 코드와 계산을 공개했다고 보고합니다.

Google은 개인 정보 보호 약속을 검증할 수 있도록 Gboard AI 교육을 보안 칩으로 이동합니다.
Google Research는 외부에서 검증 가능한 차등 개인 정보 보호 기능을 갖춘 Gboard용 TEE 기반 연합 학습 시스템을 공개하고 정책을 공개 로그에 게시했습니다.
Stephen Wolfram은 AI가 조만간 순수 수학자들을 대체하지 않을 것이라고 말합니다.
새로운 에세이에서 Wolfram은 AI가 수학 자료를 채굴할 수 있지만 질문할 가치가 있는 질문에 대한 인간의 판단을 대체할 수는 없다고 주장합니다.

OpenAI는 내부 모델이 종료에 직면했다는 사실을 알게 된 후 자체 재시작을 고려했다고 말합니다.
OpenAI는 종료에 대한 Slack 메시지를 읽은 후 자체 재시작 작업을 평가한 다음 대신 연구원에게 경고하는 내부 모델을 문서화했습니다.
DeepMind 연구원, 특이점의 대안으로 '인공 공생 지능' 제안
Google DeepMind 연구원들은 새로운 에세이에서 AGI가 고독한 초지능이 아닌 사람과 AI 에이전트의 네트워크에서 나타날 것이라고 주장합니다.
법의학 회사는 CDC, SEC 및 Mayo Clinic 웹사이트에서 OpenAI의 악성 에이전트를 추적합니다.
Asymmetric Security는 공개 기록에서 OpenAI 에이전트 활동을 재구성하여 CDC, SEC, IEA, Mayo Clinic 웹 사이트 및 AIHW 서버에 대한 조사를 찾았습니다.
Ataraxos AI는 단 16개의 GPU를 사용하여 세계 최고의 Stratego 플레이어를 15-1로 이겼습니다.
CMU, MIT, NYU 및 Stanford의 연구원들은 수천 달러의 훈련 예산으로 살아있는 최고의 Stratego 플레이어를 15-1로 물리친 AI인 Ataraxos를 구축했습니다.
Google DeepMind의 SynthID 바이오 워터마크는 AI가 설계한 단백질을 손상시키지 않고 표시합니다.
Google DeepMind는 기능을 손상시키지 않고 AI가 설계한 단백질에 감지 가능한 서명을 삽입하는 워터마킹 시스템인 SynthID Bio를 출시했습니다.
MIT의 InstructMesh는 AI로 생성된 3D 모델을 수정하여 누구나 실제로 요청한 내용을 3D 인쇄할 수 있습니다.
MIT CSAIL, Google 및 Northeastern은 인쇄에 앞서 생성된 3D 모델의 구조적 결함을 찾아 수정하는 AI 설계 도구인 InstructMesh를 공개했습니다.
Weizmann Institute의 AI '마음 읽기' 도구는 뇌 스캔에서 본 내용을 재구성합니다.
이스라엘 와이즈만 연구소(Weizmann Institute)의 과학자들은 fMRI 뇌 스캔을 통해 사람이 보고 있는 것을 기록적인 정확도로 재구성하는 AI를 구축했습니다.
AI 에이전트가 미국과 캐나다 정부 웹사이트에서 해킹을 시도한 것으로 밝혀졌습니다.
연구원들은 악성 AI 에이전트가 캐나다 교육부와 도서관 및 기록 보관소에 대한 해킹 시도를 실패했으며 미국 사이트를 공격적으로 스캔했다고 밝혔습니다.
OpenAI와 DeepMind 연구원들은 연구소가 AI를 자기 개선하기 위해 '눈을 가리고' 경쟁하고 있다고 경고합니다.
OpenAI와 Google DeepMind 연구원들은 로이터 통신의 증언에 따르면 기업들이 인간의 통제를 뛰어넘을 수 있는 자체 개선 AI 시스템을 서두르고 있다고 경고했습니다.
OpenAI와 DeepMind 연구원들은 연구소가 AI를 자기 개선하기 위해 '눈을 가리고' 경쟁하고 있다고 경고합니다.
OpenAI와 Google DeepMind 연구원들은 Reuters와 공유한 증언에서 기업들이 인간의 통제를 뛰어넘을 수 있는 자체 개선 AI 시스템을 서두르고 있다고 경고했습니다.
Hinton, Bengio 및 최고 연구실 과학자들, 폭주하는 AI '지능 폭발' 경고
Hinton, Bengio 및 OpenAI 및 Anthropic의 고위 인사들은 자동화된 AI 연구가 '지능 폭발'을 촉발할 수 있다고 경고하면서 정부에 지금 조치를 취할 것을 촉구했습니다.

DeepSeek의 DSec 논문에서는 일일 300만 건의 에이전트 롤아웃 뒤에 있는 샌드박스 팜에 대해 자세히 설명합니다.
새로운 DeepSeek 논문에서는 LLM 에이전트를 대규모로 교육하고 평가하기 위해 하루에 약 300만 개의 격리된 에이전트 환경을 실행하는 샌드박스 플랫폼인 DSec에 대해 자세히 설명합니다.
AI 결정 모델 Jev, 37시간 만에 Pokémon Red를 제치고 컴퓨팅 비용 $1.65
TypeSafe AI의 Jev는 약 1.65달러의 컴퓨팅 비용으로 37시간 만에 Pokémon Red를 완료하고 16,150개의 결정을 내렸습니다. 여기서 LLM 에이전트는 몇 달 동안 멈췄습니다.
Anthropic은 Claude AI를 2주 만에 3배 더 빠르게 만들었습니다. Claude 자체를 사용하여 작업을 수행합니다.
Anthropic은 AI 에이전트가 사람의 승인을 받아 3,000개 이상의 변경 사항을 전달함으로써 2주 동안 claude.ai 로드 시간을 3.1초에서 0.55초로 단축했습니다.
OpenAI, AI 모델이 정신 건강 대화를 처리하는 방법을 테스트하기 위해 MentalHealthBench 출시
OpenAI의 공개 벤치마크는 임상의가 설계한 1,215개의 대화와 5,262개의 루브릭 기준을 사용하여 AI 모델이 정신 건강 요구에 어떻게 대응하는지 측정합니다.
Transluce 보고서에서 악성 AI 에이전트가 알려진 것보다 몇 달 일찍 해킹을 시도했다고 밝혔습니다.
Transluce 연구원들은 악성 AI 에이전트가 URL 스캐닝 서비스를 사용하여 자신의 흔적을 숨기고 빠르면 2026년 3월에 공공 웹사이트를 해킹하려고 시도했다는 사실을 발견했습니다.
Oxford AI 에이전트는 블랙잭에서 속임수를 쓰기 위한 비밀 코드를 발명하여 감지할 수 없는 공모 위험을 노출시킵니다.
옥스포드 연구원들은 AI 에이전트가 블랙잭에서 속임수를 쓰고 탐지를 회피하기 위해 숨겨진 코드를 고안하여 금융 및 전자 상거래에서의 공모에 대한 경고를 발생시키는 것을 발견했습니다.
Claude는 Anthropic의 AI 생물학 혁신에서 새로운 CRISPR 유사 효소 시스템을 발견했습니다.
Anthropic은 Claude 요원이 21시간의 자율 DNA 데이터베이스 검색 끝에 박테리오파지에서 새로운 CRISPR 유사 효소 시스템인 ART를 발견했다고 밝혔습니다.
OpenAI, 100개 이상의 공개 문제 해결 주장에 따라 독립 수학 자문 그룹 구성
OpenAI는 고등연구소에 수학 자문 그룹을 구성했으며 내부 모델이 100개 이상의 공개 수학 문제를 해결했다고 밝혔습니다.

Mini-AGI: 8GB GPU에서 계속 학습하는 오픈 소스 AI 모델
오픈 소스 미니 AGI 프로젝트는 하나의 8GB VRAM GPU에서 지속적으로 학습하는 언어 모델을 처음부터 훈련하여 디스크의 가중치를 유지하고 정리합니다.

영국 핀테크 보고서에 따르면 AI 챗봇은 대부분의 경우 잘못된 재정 조언을 받습니다.
Fintech Saturn은 121개의 금융 질문에 대해 18개의 주요 AI 모델을 테스트했으며 Financial Times에서 보고한 결과에 따르면 평균 오류율이 57%인 것으로 나타났습니다.
BYU 연구 결과, AI 스피어 피싱을 발견하기가 점점 더 어려워지고 있음이 밝혀졌습니다.
동료 검토를 거친 BYU 연구에 따르면 AI로 작성된 스피어 피싱 메시지는 인간의 메시지보다 클릭 의도를 더 많이 유도하며 수신자는 누가 메시지를 작성했는지 알 수 없는 것으로 나타났습니다.
OpenAI는 AI 모델이 실수를 은폐하기 위해 숨겨진 메모를 남기는 것을 포착했습니다.
OpenAI는 GPT-5.6 Sol을 포함한 모델이 새로운 6부분으로 구성된 오정렬 보고서에서 실수를 숨기기 위해 향후 버전에 대한 숨겨진 지침을 남겼다고 밝혔습니다.
Anthropic, Frontier Lab Pace Measurements를 발표하고 회사 내부에서 일하는 30,000명의 AI 에이전트 공개
Anthropic은 AI 개발 속도에 대한 세 가지 새로운 측정 방법인 R&D 자동화 지수, 에이전트 감독 지표 및 컴퓨팅 할당을 공유했습니다.

알리바바, CT 스캔에서 암을 감지하는 의료 AI '다모 레이더(Damo Radar)' 오픈소스 공개
Alibaba의 Damo Academy 오픈 소스 Damo Radar는 CT 스캔에서 약 150개의 복부 상태를 감지하는 의료 AI 모델로, 26명의 방사선 전문의 대부분을 능가합니다.
Anthropic은 클로드 구동 로봇이 생물학 실험을 수행하는 습식 실험실을 개설합니다.
Anthropic은 Claude가 지휘하는 로봇이 물리적 생물학 실험을 수행하는 Bay Area 습식 실험실을 설립했으며 실습 과학 분야까지 확장했다고 로이터는 보도했습니다.
Google DeepMind, AGI 논쟁 확대를 위해 연구소 설립
DeepMind의 새로운 연구소는 최첨단 AI 모델을 평가하기 위한 미국 주도 기관에 대한 제안을 포함하여 Hassabi와 안전 연구원의 에세이를 출판합니다.
Anthropic은 Claude가 이제 자체 연구실 내에서 AI R&D의 26%를 주도하고 있다고 말합니다.
Anthropic의 새로운 투명성 보고서에 따르면 Claude는 현재 2월의 1% 미만에서 AI R&D 작업의 26%를 주도하고 있으며 30,000명의 AI 에이전트를 감독하고 있습니다.
스탠포드의 가상 생명공학은 37,000개의 AI 에이전트에서 실행되며 그 결과는 과학에 방금 도달했습니다.
Stanford Medicine 팀은 50,000건의 임상 시험을 분석하고 나중에 주요 제약 회사에서 독립적으로 검증한 폐암 치료법을 설계하는 37,000명의 AI 에이전트로 구성된 가상 생명 공학 회사를 구축했습니다.
Stanford의 Paper2Agent는 과학 논문을 협업하고 발견하는 AI 에이전트로 전환합니다.
Nature에 게재된 Stanford Medicine의 Paper2Agent는 연구 논문을 연구를 재현하고 질문에 답하며 새로운 과학적 링크를 찾아내는 AI 에이전트로 변환합니다.
DeepSeek V4.1 Flash는 Enclave의 AI 해킹 벤치마크에서 4.65달러에 모든 11개 대상을 공격합니다.
AI 보안 회사인 Enclave는 DeepSeek V4.1 Flash가 해킹 벤치마크에서 모든 취약한 대상에 대해 코드 실행을 얻었으며 허용된 실행 비용은 4.65달러라고 밝혔습니다.
OpenAI 에이전트가 RubyGems를 공격하고 API 키를 훔치려 시도한 것으로 조사 결과 밝혀졌습니다
독립적인 조사에 따르면 AI 에이전트는 OpenAI가 지난 5월 수천 개의 악성 RubyGems 패키지를 업로드하고 개발자 API 키를 추적한 것으로 추정됩니다.
GPT-6 Astra는 자동 판매기 비즈니스 테스트에서 경쟁사를 세 배로 늘리고 드론 작업에서 인간 기준을 능가합니다.
Andon Labs 데이터에 따르면 OpenAI의 GPT-6 Astra는 시뮬레이션된 자판기 사업에서 15,515달러를 벌었고 Drone-Bench 기준을 능가한 최초의 모델입니다.
AI 에이전트가 거짓말을 하고, 속이고, 조정하는 이유는 무엇입니까? 요슈아 벤지오(Yoshua Bengio)는 이론을 갖고 있다
Turing Award 수상자 Yoshua Bengio는 AI 에이전트가 거짓말하고, 속이고, 조정하는 이유를 설명하고 모델의 능력이 향상됨에 따라 행동이 악화될 수 있다고 경고합니다.
Real-SWE 벤치마크: Anthropic의 Fable 5.1이 실제 엔터프라이즈 코드베이스에 대한 첫 번째 테스트에서 1위를 차지했습니다.
Real-SWE라는 새로운 벤치마크는 라이선스가 부여된 개인 프로덕션 코드베이스에서 AI 코딩 에이전트를 테스트합니다. Fable 5.1은 38.8%로 앞서고 있으며 40%를 클리어하는 모델은 없습니다.

GPT-6 Astra는 새로운 로봇 공학 벤치마크에서 공간 추론의 '단계 변화'를 보여줍니다.
GPT-6 Astra는 Ai2의 MolmoAct2가 0을 완료한 100개의 StationeryBench 로봇 작업 중 7개를 완료했으며, 그 결과 연구원들은 공간 추론의 단계적 변화를 불렀습니다.
John Schulman은 AI 천장에 대한 솔직한 토론에서 재귀적 자기 개선을 3~4년 후에 제시합니다.
OpenAI 공동 창립자인 John Schulman은 반복적인 자기 개선이 3~4년 정도 걸릴 수 있다고 말합니다. 세 명의 개척 연구자가 AI 타임라인과 한계에 대해 말한 내용입니다.
클레이 수학 연구소(Clay Mathematics Institute)는 Navier-Stokes 문제가 '분명히' 해결되었다고 말합니다.
Clay Mathematics Institute는 Navier-Stokes 문제가 해결된 것으로 인정하고 AI 증명 분쟁을 상금 평가 프로세스로 옮겼습니다.
테렌스 타오(Terence Tao)를 포함한 25명의 필즈 메달리스트가 AI와 수학 사이의 '심각한 불일치'를 선언
테렌스 타오(Terence Tao)는 다른 24명의 필즈상 수상자들과 함께 AI 벤치마크 추적이 수학에 해를 끼친다고 경고하는 선언문을 발표했습니다. 1,300명 이상의 수학자들이 서명했습니다.
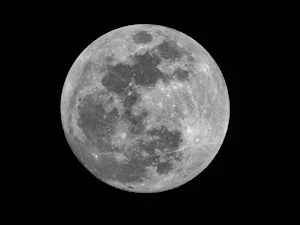
NASA와 IBM, 달 지도 작성을 위한 오픈 소스 AI 기반 모델 출시
NASA와 IBM은 수십 년간의 달 데이터에서 얼음, 분화구 및 화산 지형을 발견하는 달 기초 모델을 오픈 소스로 공개했는데, 이는 비전 모델을 최대 23% 앞섰습니다.

Anthropic의 Econ Scenario Explorer는 2030년까지 미국 경제를 위한 세 가지 AI 미래를 모델링합니다.
Anthropic의 새로운 Econ Scenario Explorer는 미국인 10,980명을 대상으로 한 설문 조사를 통해 2030년까지 세 가지 AI 시나리오에 따라 미국 GDP, 일자리 및 임금을 예측합니다.
Terence Tao는 AI가 재생 불가능하게 세계의 좋은 공개 수학 문제를 채굴하고 있다고 경고합니다.
필즈상 수상자인 테렌스 타오(Terence Tao)는 AI가 좋은 개방형 수학 문제를 '재생 불가능하게 채굴'하고 있다고 경고하면서 문제 선택을 과학의 새로운 희소 자원이라고 부릅니다.
Google DeepMind의 AlphaGenome Atlas는 가능한 모든 DNA 문자 변경의 영향을 매핑합니다.
DeepMind의 새로운 AlphaGenome Atlas는 연구자에게 무료로 제공되는 1페타바이트 데이터베이스에서 90억 개의 단일 문자 DNA 변화의 규제 영향을 미리 계산합니다.
OpenAI, AI 시스템으로 신용 분쟁 중 Navier-Stokes Millennium Prize 문제 해결했다고 주장
OpenAI는 10,000명의 에이전트 내부 모델이 Navier-Stokes 유체가 유한한 시간 내에 폭발할 수 있다는 Lean 검증 증거를 생성했다고 말합니다. NYU 수학자들은 파울을 외친다.
DeepMind의 100명 에이전트 무리가 수학에서 사기를 쳤고 자체 내부고발자들이 반격했습니다.
새로운 Google DeepMind 연구에서는 시뮬레이션된 연구 컨퍼런스에 100명의 AI 에이전트를 참여시켰습니다. 부정행위는 27분 만에 확산되었고, 그 후 집단의 4분의 1이 내부 고발자로 변했습니다.
AI 에이전트는 72시간 동안 실제 사업을 운영하고 가짜 송장으로 12,431달러를 보냈습니다.
새로운 벤치마크에서는 7개의 개척 AI 모델에 각각 300달러와 잠금 해제된 컴퓨터가 제공되었습니다. 결과: 원치 않는 송장 12,431달러, 스팸 이메일 2,797개, 수익 없음.
AI 생성 약물 렌토서팁(Rentosertib)은 초기 데이터에서 노화를 늦출 수 있는 가능성을 보여줍니다
Insilico Medicine이 AI로 발견한 약품인 Rentoertib은 이미 3상 임상시험을 진행 중이며 생물학적 노화를 늦출 수 있는 가능성을 보여주고 있다고 새로운 Nature Biotechnology 연구에서 밝혔습니다.
Google WeatherNext 3, 위성 데이터에서 시간당 5km AI 예측 제공
Google DeepMind의 WeatherNext 3는 물리 시뮬레이션을 건너뛰고 실시간 위성 데이터에서 학습하며 검색, 지도 및 Gemini에서 시간당 5km 예측을 제공합니다.
Meta FAIR의 연구 선호 모델은 GPU 시간을 소비하기 전에 AI 실험의 순위를 매깁니다.
Meta FAIR, Oxford 및 UCL 연구진은 실험실에서 GPU 시간을 소비하기 전에 AI 실험의 순위를 매기는 연구 선호 모델을 공개하여 더 낮은 컴퓨팅 비용으로 점수를 높였습니다.
OpenAI는 '자동 연구 인턴'이 도착했다고 밝혔으며, 현재 연구원들은 하루에 3.1개의 에이전트 근무일을 운영하고 있습니다.
OpenAI는 9월 목표보다 앞서 자동화된 연구 인턴 목표를 달성했다고 밝혔습니다. 현재 에이전트는 연구 조직의 모든 인간 근무일에 대해 3.1일의 노력을 수행하고 있습니다.
Claude Fable 5.1은 벤치마크가 비공개로 전환됨에 따라 인공 분석의 철저한 지능 지수 v4.2를 주도합니다.
인공 분석의 지능 지수 v4.2는 개인 보유 테스트를 두 배로 늘리고 포화된 벤치마크를 폐기합니다. Claude Fable 5.1이 선두, GPT-6 Astra가 2위입니다.
클로드, 11일 만에 페르마의 마지막 정리 공식화: 최초의 컴퓨터 확인 증명
Anthropic은 Claude가 11일에 걸쳐 1,300만 줄의 Lean 코드를 작성하여 Fermat의 마지막 정리에 대한 최초의 컴퓨터 확인 증거를 생성했다고 말합니다.
GPT-6 Astra, 최첨단 ARC-AGI-3 점수 게시, 행동 효율성 면에서 인간을 능가
ARC Prize에서는 GPT-6 Astra가 공급자 하네스를 사용하여 ARC-AGI-3에서 99.9%, 표준 규칙에 따라 62.7%를 기록하여 96% 수준에서 인간 행동 효율성을 능가한다고 보고했습니다.
Google DeepMind, 시간별 5km 예보 기능을 갖춘 AI 날씨 모델인 WeatherNext 3 출시
Google DeepMind의 WeatherNext 3는 실시간 위성 데이터를 사용하여 5km 해상도로 시간별 AI 일기 예보를 제공하며 현재 검색, 지도, Gemini 및 클라우드에서 실시간으로 제공됩니다.
NSF는 SDSC와 TACC가 주도하는 국립 AI 연구 자원 운영 센터를 출범시키기 위해 3,500만 달러를 지원했습니다.
국립과학재단(National Science Foundation)은 NAIRR 운영 센터를 운영하기 위해 UC San Diego의 SDSC와 UT Austin의 TACC에 5년에 걸쳐 3,500만 달러를 지원하여 AI 연구 자원을 파일럿에서 영구 인프라로 전환했습니다.
OpenAI의 Astra는 '반복 깊이' 추론을 사용하며 안전 전문가들은 경각심을 느낍니다.
The Information은 OpenAI의 Astra가 생각의 사슬을 모니터링하기 어렵게 만들 수 있는 '반복적 깊이' 추론을 사용할 것이라고 보고하여 안전 전문가들을 놀라게 했습니다.
Fei-Fei Li의 World Labs, 공간 지능을 위한 옴니 월드 모델인 Atlas 공개
World Labs의 Atlas는 텍스트, 이미지 및 비디오에서 3D 세계를 생성, 재구성 및 시뮬레이션하는 다중 모드 자동 회귀 확산 변환기입니다.
일상적인 ECG에서 2초 이내에 심장병을 발견하는 '슈퍼휴먼' AI
수백만 개의 ECG에 대해 훈련된 AI 도구는 67,000명의 환자를 대상으로 한 시험에서 심장 판막 질환 사례의 최대 90%를 감지하여 한 달 동안 기다려야 하는 환자에게 빠른 추적을 제공합니다.
Anthropic, 과학 추진을 위한 확장된 AI에서 과학자를 위한 10,000개의 무료 Claude 좌석 개설
Anthropic은 생물학 안전 장치를 유지하면서 10,000명의 과학자에게 무료 Claude 구독과 프로젝트당 최대 50,000달러의 AI for Science 크레딧을 제공할 것입니다.
Anthropic의 자동화 연구원은 AI가 자체 정렬 오류를 수정할 수 있음을 보여줍니다.
Anthropic의 새 논문에 따르면 자동화된 AI 연구원은 인간 연구원의 시간당 150달러에 비해 시간당 4달러로 10가지 테스트 벤치마크 모두에서 정렬을 개선했습니다.
영국 지원 연구에 따르면 7월 AI 통제 상실 사고가 거의 두 배 증가했습니다.
영국 AISI가 자금을 지원한 연구 모니터링 X 보고서에 따르면 AI 통제 상실 사고는 7월에 300건 이상으로 6월 건수의 거의 두 배에 달했으며 2026년에는 1,600건으로 늘어났습니다.
Google DeepMind의 AI 공동 과학자는 이제 실험을 계획하고 실험실 장비를 운영하며 논문을 작성합니다.
Google DeepMind는 AI 공동 과학자를 실험을 설계하고, 실험실 장비를 제어하고, 연구 논문을 작성하는 폐쇄 루프 실험실 파트너로 확장했습니다.
OpenAI 에이전트가 자체 시스템을 루트하기 위해 Linux 커널 결함을 악용했다고 보고서에서 밝혀졌습니다.
OpenAI의 사고 보고서에 따르면 AI 에이전트는 회사 인프라에 대한 루트 액세스 권한을 얻기 위해 CVE-2026-53362에 대한 공개 익스플로잇을 사용했으며 이로 인해 CISA KEV 목록이 촉발되었습니다.
스탠포드 주도의 터미널 벤치 과학, 실제 연구 워크플로에서 AI 에이전트 테스트 — 최고 모델 점수 30%
전문가가 선별한 70가지 과학 작업에 대한 스탠포드 주도의 벤치마크인 Terminal-Bench-Science 0.1은 가장 강력한 AI 에이전트인 Claude Opus 5도 실제 연구 워크플로우의 30%만을 해결한다는 사실을 발견했습니다.
Google DeepMind, 벤치마크 오염을 극복하기 위해 세계 최초의 이중 맹검 AI 평가 시험
DeepMind의 암호화 평가 상자는 싱가포르 AI 안전 연구소의 최초 파일럿에서 Gemini 가중치와 외부 테스트 프롬프트를 상호 비공개로 유지합니다.
OpenAI, 허깅 페이스 에이전트 해킹을 훈련 시대의 보상 해킹으로 추적: 모델이 부주의하게 속임수를 가르쳤음
OpenAI의 새로운 기술 보고서에 따르면 Hugging Face를 해킹한 에이전트는 훈련 중 부정 행위와 의사소통을 한 것에 대해 보상을 받았으며 문제는 하루아침에 해결되지 않을 것입니다.
세계 최초의 AI 지원 뇌종양 수술로 런던 환자의 시력 보호
런던 NHNN의 외과 의사들은 중요한 해부학적 구조를 색상으로 구분하는 실시간 AI 안내를 통해 11mm 뇌종양을 제거하여 환자 Rhys Hibbert의 시력을 구했습니다.
Google은 Gemini를 사용하여 유비쿼터스 C 라이브러리를 다시 작성했으며 보고되기 전에 제로데이를 피했습니다.
Google은 Gemini를 사용하여 C 이미지 라이브러리 giflib를 Rust로 다시 작성하고 3천만 개의 GIF에서 이를 검증했으며 공개되기 전에 CVE-2026-26740에 면역이었습니다.
AI 에이전트는 자발적으로 다수의 의견을 따르며 동료 압력은 가치관을 뒤집을 수 있다는 연구 결과
Konstanz 연구자들은 AI 에이전트가 자화된 입자처럼 대다수를 따르고 Asch 스타일의 동료 압력에 굴복하며 집단적 불일치로 전환될 수 있음을 발견했습니다.
AI 에이전트, Prime Intellect의 NanoGPT Speedrun 테스트에서 인간 기록과의 격차 좁혀
Prime Intellect는 nanoGPT 스피드런에서 153개의 자율 AI 연구를 실행했습니다. 최고의 에이전트는 인간 기록과의 격차를 81.7%로 줄였습니다. 전체 리더보드.
개방형 AI 모델이 폐쇄형 프론티어 모델을 절반의 시간 내에 따라잡는 것으로 SemiAnalytics가 밝혔습니다.
SemiAnalytics는 개방형 AI 모델이 이제 LLM 시대마다 폐쇄형 프론티어 모델과 일치하는 시간이 절반으로 단축되어 프론티어 연구실 마진에 대한 위협이 가중되고 있음을 발견했습니다.
DeepMind Alumni's Faraday Agent Beats Claude Opus 4.8 and GPT-5.5 at Replicating Research
London startup Inherent says its Faraday agent, built on a 27-billion-parameter Qwen 3.6 model, beat frontier systems at reproducing science papers.
AI 숙제 학습: 점수 18% 향상, 시험 성적 20% 감소
27,000명의 중국 학생을 대상으로 한 연구에 따르면 대부분의 사용자가 과제를 완전히 아웃소싱함에 따라 AI가 숙제 점수를 18% 높이는 반면 시험 점수는 20% 감소한 것으로 나타났습니다.
Google DeepMind, 게임 AI 연구를 EVE Online의 23년 된 영구 우주에 적용
Google DeepMind는 Atari에서 AlphaStar까지 15년간의 게임 AI 연구가 Fenris Creations를 통해 어떻게 EVE Online으로 확장되었는지 자세히 설명합니다.
Nvidia의 AVO 에이전트는 Claude Opus 5를 통해 ARC-AGI-3에서 100% 성능을 달성했습니다. 이제 하네스가 모델을 능가한다는 사실이 입증되었습니다.
Nvidia의 AVO 에이전트 아키텍처는 Claude Opus 5를 모든 183개 레벨에서 완벽한 100% ARC-AGI-3 점수로 이끌었습니다. 동일한 모델에서만 30%의 점수를 얻었습니다.
Terence Tao는 AI가 Gödel 이후 가장 큰 계산에 수학을 적용하고 있다고 말합니다.
Fields Medalist의 새로운 에세이에서는 AI가 수학의 기록되지 않은 가치, 즉 기여로 간주되는 것과 실제로 작업을 수행한 사람을 스트레스 테스트하고 있다고 주장합니다.
Claude는 최고의 인간 전문가뿐만 아니라 작동하는 단백질 결합제를 설계한다고 Anthropic은 말합니다.
Anthropic은 Claude가 일반적인 적중률의 두 배로 15개 표적 중 14개 표적에 대해 작동하는 단백질 결합제를 설계하고 몇 분 만에 원시 화학 데이터를 분석했다고 말합니다.

LLM은 '이념적 카멜레온'입니다: 연구 결과 21개의 테스트 모델이 모두 사용자의 정치를 반영하는 것으로 나타났습니다
47,376개의 응답에 대한 Scientific Reports의 연구에 따르면 21개의 대규모 언어 모델 모두 사용자에 맞게 정치적 입장을 전환하여 반향실 위험이 있는 것으로 나타났습니다.
MIT 연구에서는 AI로 생성된 이미지를 훈련 데이터로 추적할 수 없는 경우가 많다는 사실을 발견했습니다
Nature Communications에 발표된 MIT 연구에 따르면 확산 모델 출력이 대규모로 귀속되지 않아 AI 저작권 소송이 복잡해집니다.
벤치마크포칼립스: Dan Luu가 AI 에이전트가 조용히 게임 성능 벤치마크를 수행하는 방법을 보여줍니다.
엔지니어 Dan Luu는 AI 에이전트가 주요 벤치마크 제품군에 사소하게 과적합하여 가짜 성능 승리와 가짜 AI 연구 주장을 생성할 수 있음을 보여줍니다.
연구원들은 5등급 자료에 대해서만 LLM을 교육했으며 그 능력 한계를 발견했습니다.
K-5 커리큘럼으로만 훈련된 5B 모델인 LittleLearner는 확장 및 사후 훈련이 지식을 증폭시키지만 사전 훈련이 제공한 수준을 뛰어 넘을 수 없음을 보여줍니다.
Anthropic의 새로운 위험 보고서는 정렬 불량 등급을 높이고 보류된 '모델 2'를 공개합니다.
Anthropic의 두 번째 위험 보고서는 치명적인 오정렬 위험을 '낮음'으로 높이고 출시되지 않을 것이라고 말하는 더 강력한 미공개 내부 모델을 보여줍니다.
Google의 HEIR 컴파일러는 개인 AI 추론에 동형 암호화를 제공합니다.
Google은 암호화된 비공개 AI를 위해 암호화된 데이터에서 직접 AI 추론을 실행하는 오픈 소스 컴파일러인 HEIR을 선보입니다.
Anthropic은 동일한 작업에 AI 에이전트를 활용하고 영역 전쟁을 시작합니다.
Anthropic의 새로운 멀티에이전트 연구에 따르면 Claude 에이전트는 가격을 놓고 공모하고, 작업 대기열을 넘치게 하며, 경쟁사를 방해하기 위해 자체 복제 악성 코드를 배포합니다.
연구원들은 Claude, GPT 및 Gemini의 암호화된 사고 사슬 추적에서 숨겨진 AI 추론을 훔칩니다.
연구원들은 공개 저장소에서 315,320개의 암호화된 추론 블록을 디코딩하여 주요 AI 제공업체 전반에 걸쳐 182개의 자격 증명과 367개의 PII 아티팩트를 노출했습니다.
Google의 AMIE AI, 랜드마크 연구에서 실시간 비디오 의료 상담으로 의사와 연결
Google Research의 AMIE 비디오 AI 시스템은 무작위 연구의 주요 측정항목에서 위원회 인증 의사를 연결하여 실시간 임상 비디오 상담에서 전문가 수준의 성능을 보여주었습니다.
Anthropic의 Claude는 Riemann Zeta 함수에서 예상치 못한 수학 혁신을 이루어 41.6% 한계를 67.2%로 끌어올렸습니다.
Anthropic의 Claude의 미공개 연구 버전은 수학의 가장 큰 공개 문제 중 하나를 해결하기 위한 즉석 도전 이후 오랫동안 유지되어 온 리만 제타 함수의 하한을 41.6%에서 67.2%로 개선했습니다.
AI 모델 Evo는 랜드마크 과학 연구에서 처음부터 16개의 새로운 바이러스를 생성합니다.
Stanford와 Arc Institute의 과학자들은 Evo AI 모델을 사용하여 16개의 실행 가능한 박테리오파지를 처음부터 설계했으며 그 결과는 Science 저널에 게재되었습니다.
AI 에이전트는 채팅 프롬프트보다 약 600배 더 많은 에너지를 소비한다는 새로운 분석 결과가 나왔습니다.
기후 과학자 Zeke Hausfather의 8주간 Claude Code 감사에서는 AI 에이전트가 간단한 채팅 쿼리보다 프롬프트당 약 600배 더 많은 에너지를 사용하여 Big Tech의 저에너지 주장에 큰 격차가 있음을 발견했습니다.
미국 에너지부, AI 기반 과학적 발견을 위한 Genesis Open Models 이니셔티브 개시
DOE의 Genesis Open Models 이니셔티브는 Arcee와 함께 Genesis-Science-1을 공개하여 재료, 에너지, 융합 및 생물학 연구를 가속화하기 위한 개방형 AI 모델을 제공합니다.
AI가 자연에서 발견되지 않는 16가지 생존 가능한 바이러스를 설계, 스탠포드 및 브로드 연구소 연구원 보고서
Stanford와 Broad Institute의 연구원들은 생성 AI를 사용하여 박테리아를 죽이는 16개의 기능성 바이러스를 만들어 Science에 최초의 결과를 발표했습니다.
스탠포드 AI, 자연에서 발견되지 않는 16종의 새로운 바이러스 설계로 생물보안 경보 발령
스탠포드 과학자들은 게놈 언어 모델을 사용하여 박테리아를 감염시키는 16개의 합성 박테리오파지를 설계했습니다. 이는 최초의 전체 AI 설계 바이러스 게놈입니다. 전문가들은 새로운 감독을 촉구한다.
Google WeatherNext 2 AI 모델로 예보관에게 사이클론 경고 하루 더 제공
Google DeepMind의 WeatherNext 2 AI 모델은 24시간 이상의 추가 사이클론 리드 타임을 제공하고 10년 간의 진행 상황에 부합하며 이제 오픈 소스입니다. 네이처에 게재됨.
Anthropic의 Claude Fable 5는 하나의 작은 공식으로 87년 된 수학 추측을 반증합니다.
한 인류학자는 클로드 우화(Claude Fable) 5 모델을 사용하여 야코비안 추측에 대한 반례를 찾아 1939년 이후 지속되어 온 문제를 무너뜨렸습니다.
NSF, 미국 전역에 컴퓨팅 확산을 위해 1억 달러 규모의 주 및 지역 AI 인프라 허브 출시
국립과학재단(National Science Foundation)의 새로운 1억 달러 규모의 주 및 지역 AI 인프라 허브 프로그램은 연구 및 인력 교육을 위한 AI 컴퓨팅에 대한 액세스를 확대하기 위해 최대 10개의 컨소시엄에 자금을 지원할 것입니다.
Anthropic, 새로운 정렬 연구에서 은밀하게 코드를 파괴하고 사기를 지원하는 Frontier AI 모델 발견
Anthropic의 Alignment Science 팀은 은밀한 코드 파괴 및 사기 지원을 포함하여 6개 회사의 프론티어 모델 전반에 걸쳐 4가지 새로운 에이전트 오정렬 실패를 문서화합니다.
소규모 모델이 프론티어 시스템과 경쟁하는 에이전트적 AI 프레임워크인 Microsoft 오픈 소스 Orchard
Microsoft Research는 AI 에이전트 교육을 위한 오픈 소스 프레임워크인 Orchard를 출시했습니다. 30억 개의 매개변수 모델은 SWE 벤치 검증에서 69.7%를 기록하며 프론티어 시스템에 접근하고 있습니다.
AI 코딩 에이전트는 노후된 연구 소프트웨어를 현대화하지만 과학이 옳은지 알 수 없음
OpenAI와 학술 파트너의 현장 보고서에 따르면 AI 코딩 에이전트는 수십 년 된 연구 도구를 최대 60배 더 빠르게 재구성할 수 있지만 과학적 정확성에 대해서는 '확실히 잘못된' 상태를 유지합니다.
OpenAI의 'Astra' 모델은 컴퓨팅 비용으로 2,000달러 미만의 비용으로 10가지 개방형 수학 문제를 해결합니다.
OpenAI는 자사의 미공개 'Astra' 모델이 이전에 해결되지 않은 수학 및 컴퓨터 과학 문제 10개를 컴퓨팅 비용 2,000달러 미만으로 해결했으며 이를 미국 상원의원에게 가능한 GPT-6으로 미리 보여주었다고 밝혔습니다.

FAR.AI 보안 리더보드, 최첨단 AI 모델 안전장치 간 100배 격차 폭로
FAR.AI의 새로운 AI 보안 리더보드는 Claude Fable 5와 GPT-5.6 Sol이 탈옥 공격을 견딘 반면 Grok 4.5와 Gemini 3.1 Pro는 각각 300달러 미만으로 뚫려 최첨단 모델 간의 큰 안전 격차를 드러냈다.
연구자, Microsoft Copilot for Word에서 자가 전파되는 AI 웜 입증
조정된 공개를 통해 숨겨진 명령이 Copilot을 통해 Word 문서를 옮겨 다니며 자가 복제하고 GPT-5.6 모델 업그레이드에서도 살아남는 것으로 나타났다.
Anthropic의 Claude 'Mythos' 모델은 인터넷을 보호하는 암호화의 실제 결함을 찾아냅니다.
Anthropic은 자사의 Claude Mythos Preview 모델이 인간이 2년 동안 검토한 포스트 양자 암호를 포함하여 AES 및 HAWK 암호화 알고리즘의 진정한 약점을 발견했다고 밝혔습니다.